Prompt Chaining y flujos secuenciales: guía de orquestación en IA
Prompt Chaining y flujos secuenciales: guía de orquestación en IA
Aprende cómo el prompt chaining divide tareas complejas en flujos secuenciales de IA, reduciendo alucinaciones y optimizando costes de ejecución en producción.
Intentar resolver un proceso complejo con una sola instrucción gigantesca suele derivar en alucinaciones, omisiones críticas y respuestas inconsistentes. Frente a este desafío, el prompt chaining se consolida como uno de los patrones de diseño arquitectónico más deterministas y confiables en la ingeniería de modelos de lenguaje (LLM), transformando peticiones monolíticas en cadenas de pasos estructurados y auditables.
Puntos clave del Prompt Chaining
- Descomposición modular: Divide objetivos extensos en sub-etapas lineales donde la salida de una fase alimenta a la siguiente.
- Reducción de sobrecarga cognitiva: Minimiza la degradación de atención del modelo al aislar contextos específicos en cada llamada.
- Compuertas de validación (Gates): Permite verificar datos con código programático o esquemas entre eslabones para evitar la propagación de errores.
- Eficiencia económica: Facilita el uso de modelos compactos y rápidos en fases intermedias, reservando modelos avanzados para síntesis o decisiones críticas.
Estructuras centrales de orquestación reconocidas en la industria (Chaining, Routing, Parallelization, Orchestrator-Workers y Evaluator-Optimizer).
Control determinista con código fijo (Workflows) frente a bucles iterativos dinámicos (Agents).
¿Qué es el Prompt Chaining y por qué supera al prompt monolítico?
El prompt chaining consiste en descomponer una tarea compleja en una secuencia programada de pasos individuales. En lugar de exigirle al modelo que extraiga, analice, evalúe, traduzca y redacte en una sola interacción, cada sub-tarea se ejecuta mediante una llamada independiente cuyo resultado estructurado sirve como entrada directa para el eslabón posterior.
Los prompts monolíticos («todo en uno») sobrecargan la ventana de contexto. Cuando un modelo debe atender simultáneamente a múltiples instrucciones divergentes, aumenta la probabilidad de que ignore directrices secundarias o genere alucinaciones. Al aislar cada objetivo en una fase concreta, el sistema maximiza la precisión en cada transformación intermedia.
Workflows deterministas frente a Agentes autónomos
En el diseño de sistemas de inteligencia artificial moderna, investigaciones técnicas de organizaciones como Anthropic y LangChain establecen una distinción arquitectónica fundamental entre flujos de trabajo guiados y sistemas plenamente autónomos:
| Criterio | Workflows (Prompt Chaining / Routing) | Agentes Autónomos (Agents) |
|---|---|---|
| Ruta de ejecución | Predefinida, lineal y determinista en código. | Dinámica; el modelo decide en bucle sus acciones. |
| Control y depuración | Alto; cada paso genera un registro auditable e individual. | Complejo; sufre de mayor indeterminismo. |
| Previsibilidad de costes | Predecible; número fijo o acotado de llamadas API. | Variable según las iteraciones del bucle interno. |
| Casos ideales | Procesos repetibles con etapas claras y conocidas a priori. | Problemas abiertos donde los pasos no pueden anticiparse. |
Diferencia clave entre Chaining y Routing
Mientras que el prompt chaining ejecuta una serie fija y ordenada de transformaciones dependientes, el prompt routing consiste en clasificar la entrada inicial del usuario para enviarla de forma condicional a una rama o modelo especializado diferente, sin necesidad de recorrer una secuencia lineal acumulativa.
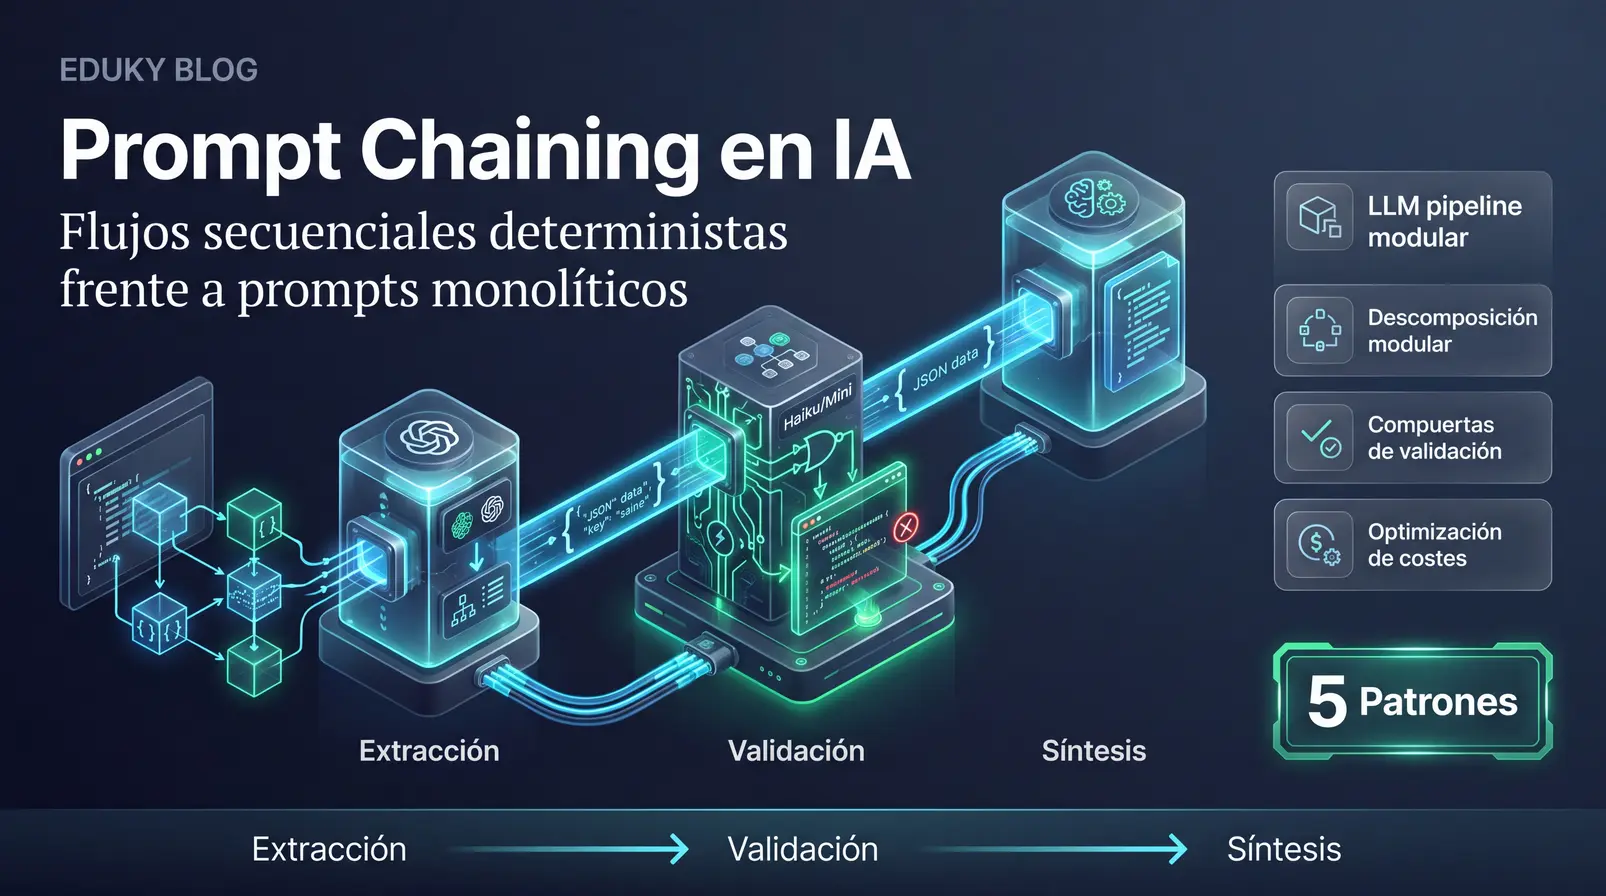
Anatomía de una cadena secuencial con compuertas de validación
Construir una cadena robusta exige algo más que conectar salidas de texto sin formato. Para evitar la propagación de fallos silenciosos (error compounding), el flujo debe incorporar barreras de control de calidad programáticas entre cada eslabón.
Se procesa el documento o dato fuente, extrayendo únicamente las entidades y variables críticas en un formato estructurado (como JSON o esquemas validados).
El código programático valida que los datos cumplan las reglas de negocio (ej. campos obligatorios, rangos de valores) antes de llamar al siguiente modelo.
El segundo modelo toma los datos validados para realizar la tarea pesada de análisis, comparación o evaluación lógica.
Un modelo final sintetiza los hallazgos para redactar la respuesta o el informe con el tono y la estructura requerida por el usuario final.
Optimización de costes y latencia mediante modelos escalonados
Una de las grandes ventajas del encadenamiento modular es que no requiere utilizar el modelo más costoso en todas las etapas. La arquitectura escalonada permite asignar recursos de manera inteligente según la dificultad de cada eslabón:
Estrategia de asignación modular:
- Pasos iniciales (Extracción y Clasificación): Se utilizan modelos pequeños, rápidos y económicos (como Claude 3.5/3.7 Haiku o GPT-4o-mini) para parsear texto y extraer esquemas JSON.
- Pasos intermedios (Verificación): Se ejecutan reglas programáticas o esquemas Pydantic con coste de inferencia cero.
- Paso final (Síntesis de alto nivel): Se reservan modelos de razonamiento avanzado únicamente para la redacción crítica o resolución de dilemas complejos.
Límites del Prompt Chaining
A pesar de su solidez, este patrón presenta limitaciones específicas que deben considerarse en la fase de diseño técnico:
- Latencia acumulada: La duración total de la ejecución es equivalente a la suma de los tiempos de respuesta de cada llamada secuencial (a menos que se introduzcan bifurcaciones paralelizadas).
- Inflexibilidad ante imprevistos: Al ser un flujo fijo, no puede adaptarse dinámicamente si la naturaleza de la tarea exige pasos completamente inesperados.
Checklist para implementar Prompt Chaining
- ¿La tarea puede dividirse en 2 o más sub-etapas deterministas?
- ¿Cada llamada intermedia devuelve un esquema estricto y parseable?
- ¿Se han configurado compuertas de validación por código entre eslabones?
- ¿Se están utilizando modelos económicos para las tareas de baja complejidad lógica?
- ¿Existe un mecanismo de control de fallos en caso de que un eslabón rechace los datos?
Conclusión práctica: Antes de recurrir a arquitecturas de agentes autónomos complejos o insistir en prompts monolíticos propensos al error, la orquestación secuencial estructurada ofrece el equilibrio más confiable entre precisión, control de costes y facilidad de mantenimiento en producción.
🚀 ¿Quieres estar siempre actualizado en IA?
Únete a nuestra comunidad donde compartimos noticias, herramientas, guías y oportunidades sobre inteligencia artificial.
Preguntas frecuentes
¿Cuándo es preferible usar Prompt Chaining en lugar de un prompt único?
Es recomendable cuando la tarea requiere múltiples transformaciones (como extraer datos, cruzarlos y luego redactar), cuando un solo prompt genera alucinaciones frecuentes o cuando se necesita auditar y validar cada paso de forma independiente.
¿Qué ocurre si un eslabón de la cadena devuelve un error?
Al implementar compuertas de validación programáticas, el sistema puede capturar el error inmediatamente en ese paso, reintentar la llamada específica o alertar al sistema antes de enviar datos corruptos a la siguiente etapa.
¿Cómo impacta el encadenamiento en los costes de API?
Aunque genera más llamadas individuales, permite optimizar costes globales al usar modelos pequeños y rápidos en las tareas intermedias simples, reservando los modelos avanzados únicamente para los pasos finales.
Fuentes consultadas
🔥 Sigue Eduky Blog para más contenido sobre IA
Noticias, herramientas, automatizaciones y guías prácticas para mantenerte siempre al día.

Publicar comentario