__usage_ai-training: el estándar unificado en robots.txt respaldado por Google, OpenAI, Anthropic y Microsoft
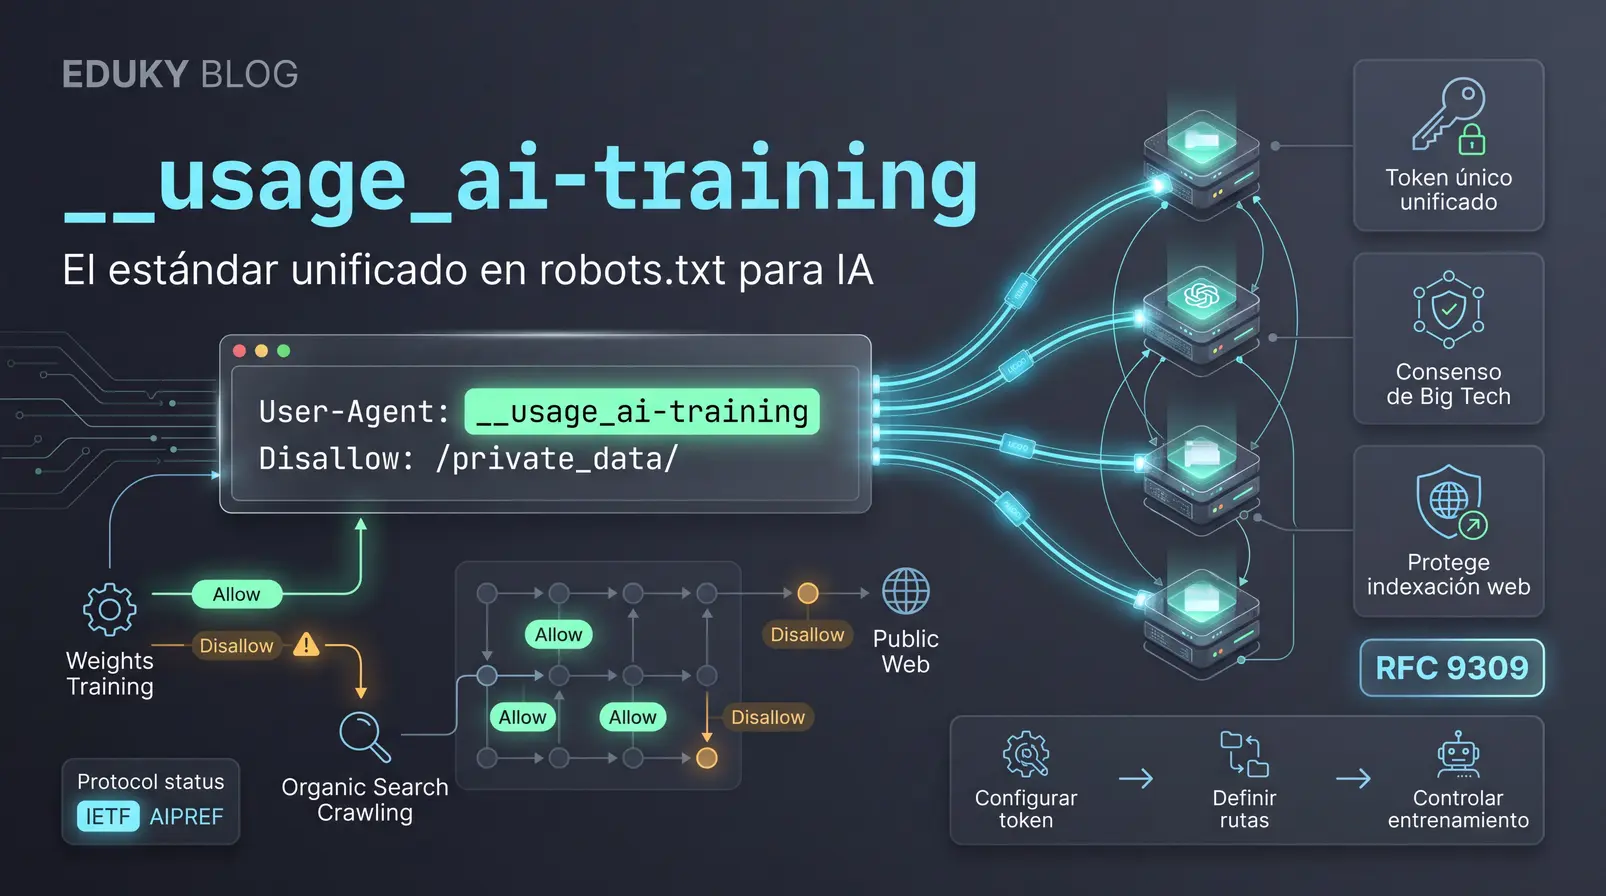
__usage_ai-training: el estándar unificado en robots.txt respaldado por Google, OpenAI, Anthropic y Microsoft
Google, OpenAI, Anthropic y Microsoft respaldan un token unificado en robots.txt para gestionar el entrenamiento de IA con una sola regla técnica.
Claves del nuevo estándar
- Propuesta formal ante IETF: Kevin Kelley de Anthropic registró el borrador técnico
draft-kelley-aipref-training-preference-signal-00dentro del grupo AIPREF. - Un solo token de control: La directiva __usage_ai-training permite a los editores web declarar con una sola línea si autorizan o prohíben el entrenamiento de modelos fundacionales.
- Consenso de gigantes: Google, OpenAI, Anthropic y Microsoft anunciaron su compromiso de respetar esta directiva.
- Diferencia crítica: El token regula el entrenamiento de parámetros (weights training), sin afectar el rastreo técnico ni la indexación web convencional.
- Implementación gradual: Los motores y laboratorios desplegarán el soporte técnico de forma escalonada entre finales de 2026 e inicios de 2027.
La gestión de permisos para rastreadores de inteligencia artificial entra en una nueva etapa de orden técnico. Hasta ahora, los administradores de sitios web debían mantener extensas listas de directivas para cada bot independiente (como GPTBot, ClaudeBot o Google-Extended). Con la llegada de __usage_ai-training, los desarrolladores y creadores de contenido obtienen un mecanismo centralizado para definir si sus páginas pueden ser utilizadas en el entrenamiento de modelos fundacionales sin alterar su presencia en los resultados de búsqueda tradicionales.
¿Qué es el borrador IETF AIPREF y cómo opera __usage_ai-training?
El 30 de octubre de 2026 se presentó formalmente ante el AI Preferences Working Group (AIPREF) de la IETF el borrador individual titulado Machine-Readable Training Preference Signal (draft-kelley-aipref-training-preference-signal-00). Este documento, cuya vigencia inicial se extiende hasta el 3 de mayo de 2027, introduce un token de política unificado sin romper la compatibilidad con el estándar existente RFC 9309 (Robots Exclusion Protocol).
La propuesta técnica sitúa a __usage_ai-training directamente dentro del campo User-Agent:. Al integrarse bajo esta estructura, no requiere reescribir los analizadores sintácticos de robots.txt, sino que aprovecha los comandos convencionales Disallow: y Allow: para delimitar qué rutas están autorizadas para nutrir modelos generativos.
Sintaxis y ejemplos de implementación en robots.txt
Para aplicar esta regla, los webmasters deben añadir el bloque correspondiente en la raíz de su dominio dentro del archivo robots.txt. La sintaxis replica el modelo tradicional de exclusión, pero asigna la semántica exclusivamente al aprendizaje computacional de los sistemas de IA.
Ejemplo 1: Bloqueo total de entrenamiento en todo el sitio
Esta configuración informa a los participantes del estándar que ningún recurso del dominio debe emplearse para modificar parámetros aprendidos de modelos de IA:
User-Agent: __usage_ai-training
Disallow: /
Ejemplo 2: Bloqueo selectivo con rutas abiertas
Si un sitio web desea restringir el contenido editorial o de pago, pero permite entrenar con su sección de documentación pública:
User-Agent: __usage_ai-training
Disallow: /articulos/
Disallow: /premium/
Allow: /documentacion/La gran encrucijada técnica: AI Training vs. AI Grounding y SEO
Uno de los puntos más determinantes al configurar __usage_ai-training es la frontera entre dos conceptos técnicos distintos: el entrenamiento de modelos (incorporar datos en los pesos de una red neuronal) y el AI grounding (recuperación en tiempo real o RAG para citar fuentes con enlaces en respuestas conversacionales).
El token ha sido diseñado exclusivamente para la fase de entrenamiento de modelos generativos y no bloquea el rastreo técnico (fetching/crawling) para la indexación web convencional. Sin embargo, los principales motores de búsqueda han anunciado interpretaciones operativas distintas:
| Plataforma | Impacto del bloqueo (__usage_ai-training) | Efecto sobre citas y Grounding | Indexación Web Orgánica |
|---|---|---|---|
| Equivalente a bloquear Google-Extended (salvo reglas explícitas). | Retira el contenido de respuestas en Gemini Apps y Vertex AI. | Mantiene la indexación normal en Google Search. | |
| Microsoft Bing | Respeta el bloqueo de entrenamiento a partir del 1 de febrero de 2027. | Mantiene controles independientes a nivel de página para grounding. | Preserva el ranking y la indexación orgánica en Bing. |
| OpenAI | Soporte programado sin eliminar el control granular de GPTBot. | Coexiste con agentes de búsqueda y navegación en tiempo real. | No aplica motor propio de rastreo orgánico general. |
| Anthropic | Desarrollo en curso para interpretar la señal unificada de forma nativa. | Sujeto a la arquitectura de uso de ClaudeBot. | No opera como motor de búsqueda web tradicional. |
Calendario de despliegue oficial de las Big Tech
La adopción del token no entrará en vigor de forma inmediata en todas las infraestructuras, sino que seguirá un cronograma coordinado durante los próximos meses:
Microsoft habilitará en su consola para administradores nuevas opciones de configuración específicas para la gobernanza de datos frente a la IA.
Google activará el reconocimiento formal del token en sus sistemas automatizados. Paralelamente, OpenAI implementará la interpretación unificada manteniendo el soporte a GPTBot y OAI-SearchBot.
Bing comenzará a respetar formalmente el token __usage_ai-training durante sus operaciones de rastreo para entrenamiento.
Microsoft dejará de interpretar las etiquetas NoArchive y NoCache como señales para excluir contenido de modelos de inteligencia artificial.
Limitaciones actuales del estándar
A pesar del consenso entre los líderes de la industria, los administradores de sistemas deben considerar las fronteras técnicas y operativas del proyecto:
- Carácter de borrador (Internet-Draft): El documento aún no constituye un RFC ratificado de forma definitiva por la IETF, por lo que su especificación formal puede recibir ajustes.
- Sin efecto retroactivo: La directiva previene ingestiones futuras, pero no purga ni elimina datos que ya fueron indexados y consolidados en modelos previamente entrenados.
- Adopción voluntaria: El protocolo se basa en el cumplimiento de buena fe. Plataformas de scraping opaco o entidades ajenas al grupo de trabajo AIPREF pueden ignorar esta instrucción.
- No detiene el tráfico de red: Al no ser un bloqueo a nivel de User-Agent general, no previene la descarga HTTP (fetching) si el crawler recopila información para otros fines permitidos.
🚀 ¿Quieres estar siempre actualizado en IA?
Únete a nuestra comunidad donde compartimos noticias, herramientas, guías y oportunidades sobre inteligencia artificial.
Preguntas frecuentes
¿Bloquear __usage_ai-training hace que mi web desaparezca de Google Search?
No. El token regula exclusivamente el uso del contenido para el entrenamiento de parámetros en modelos de IA generativa. No afecta la indexación orgánica tradicional ni el posicionamiento en los motores de búsqueda.
¿Debo eliminar de inmediato las reglas de GPTBot o Google-Extended?
No es aconsejable hacerlo de inmediato. El soporte técnico se desplegará progresivamente entre finales de 2026 y principios de 2027. Mantener las reglas existentes garantiza protección mientras los sistemas automatizados completan la transición.
¿Qué sucede si dejo mi archivo robots.txt sin este nuevo token?
Según el borrador formal de la IETF, los dominios que no declaren una regla explícita para __usage_ai-training se considerarán como sitios sin una preferencia manifestada.
Fuentes consultadas
- IETF Datatracker: Machine-Readable Training Preference Signal (draft-kelley-aipref-training-preference-signal-00)
- Google Search Central Blog: Clarifying AI training controls
- Microsoft Bing Blogs: Your content, your choice: Clearer preferences for training and grounding
- OpenAI: Helping websites express AI training preferences
- Search Engine Journal: Google, Microsoft & OpenAI Agree On AI Training Opt-Out Standard
🔥 Sigue Eduky Blog para más contenido sobre IA
Noticias, herramientas, automatizaciones y guías prácticas para mantenerte siempre al día.

Publicar comentario