Llama 3.1 405B vs Mistral Large 2: Rendimiento, Infraestructura y Licencias Corporativas
Llama 3.1 405B vs Mistral Large 2: Rendimiento, Infraestructura y Licencias Corporativas
Analizamos Llama 3.1 405B vs Mistral Large 2: comparativa técnica de benchmarks, demanda de VRAM en clústeres GPU y restricciones clave de licencia comercial.
Claves del enfrentamiento
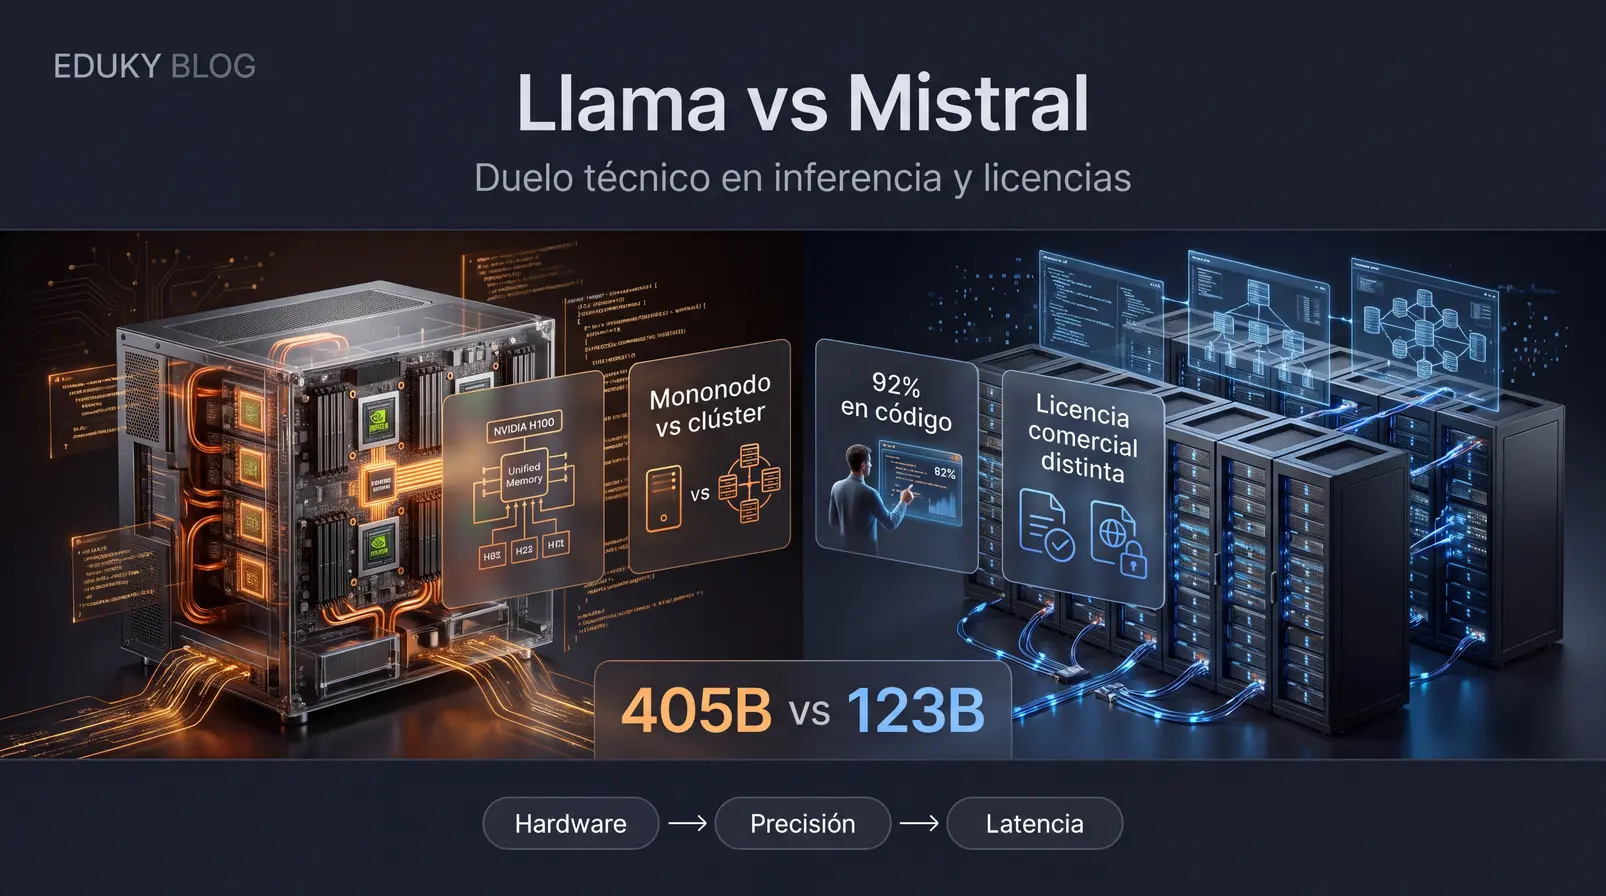
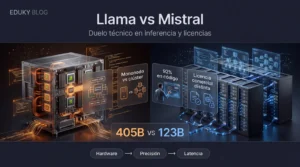
- Escala de parámetros: Llama 3.1 cuenta con 405 mil millones de parámetros (405B), frente a los 123 mil millones (123B) de Mistral Large 2.
- Infraestructura mononodo vs clúster: Mistral Large 2 está diseñado para correr en un único servidor con 8x GPUs H100 a FP16/BF16, mientras que Llama 3.1 405B exige clústeres multi-nodo o cuantización FP8/INT4.
- Código y matemáticas: Mistral Large 2 supera en generación de código (92.0% en HumanEval), mientras Llama 3.1 405B lidera en matemáticas y razonamiento general (96.8% en GSM8K y 85.2% en MMLU).
- Términos legales: Meta permite uso comercial directo y destilación hasta 700 millones de usuarios activos; Mistral aplica una licencia gratuita únicamente para investigación no comercial.
El ecosistema de modelos de pesos abiertos alcanzó un punto de inflexión con la llegada de Llama 3.1 405B vs Mistral Large 2. Ambos modelos demuestran que las arquitecturas densas no propietarias pueden competir directamente contra las soluciones cerradas más avanzadas de la industria. Sin embargo, para los equipos técnicos y directores de tecnología, la elección entre ambos no se reduce únicamente a las puntuaciones de referencia: la viabilidad técnica depende del coste de hardware por inferencia y de la letra pequeña de sus licencias de explotación.
A lo largo de este análisis desglosamos cómo se comparan en tareas clave, qué infraestructura exige cada uno para desplegarse de manera privada y cuáles son las implicaciones legales para su adopción en producción corporativa.
Arquitectura y escala: 123B frente a 405B
Ambos desarrollos han optado por alejarse de las estructuras dispersas tipo Mixture of Experts (MoE) para sus modelos insignia, apostando por arquitecturas transformer densas puras y una ventana de contexto amplia de 128.000 tokens.
Mistral Large 2 concentra su capacidad en 123B parámetros. La decisión de ingeniería detrás de este tamaño busca la eficiencia de cálculo: encajar el modelo completo en la memoria de un solo servidor industrial moderno. Por el contrario, Meta asumió una aproximación de fuerza bruta con Llama 3.1 405B, explorando el límite superior de rendimiento en pesos abiertos a costa de una huella de memoria masiva.
Benchmarks cara a cara: Razonamiento, código y rendimiento en español
La comparativa directa entre Llama 3.1 405B vs Mistral Large 2 en pruebas estandarizadas oficiales muestra resultados especializados según la tarea requerida:
| Benchmark / Métrica | Mistral Large 2 (123B) | Llama 3.1 (405B) | Enfoque principal |
|---|---|---|---|
| HumanEval | 92.0% | 89.0% | Generación y resolución de código |
| MATH Instruct (0-shot CoT) | 71.5% | Inferior / competitivo | Razonamiento matemático complejo |
| GSM8K | 93.0% | 96.8% | Aritmética y lógica paso a paso |
| MMLU General | 84.0% | 85.2% | Conocimiento multidisciplinar |
| MMLU Español | 82.7% | Competitivo | Comprensión contextual en español |
Mistral Large 2 sobresale particularmente en tareas de desarrollo de software con un 92.0% en HumanEval, aventajando en tres puntos porcentuales a la propuesta de Meta (89.0%). Asimismo, Mistral destaca por su consistencia multilingüe europea, alcanzando un 82.7% en español y 82.8% en francés en pruebas MMLU. Por su parte, Llama 3.1 405B se mantiene a la cabeza en comprensión conceptual global (85.2% MMLU) y aritmética compleja (96.8% en GSM8K).
Realidad de infraestructura: El reto de los clústeres GPU y la VRAM
El rendimiento teórico en inteligencia artificial siempre choca con la realidad operativa del centro de datos. En este punto, los requisitos de Llama 3.1 infraestructura VRAM marcan una barrera de entrada sustancial.
Mistral Large 2: Eficiencia en nodo único
Con 123 mil millones de parámetros, el modelo fue optimizado intencionalmente para ser alojado en un único nodo HGX compuesto por 8 GPUs Nvidia H100 (80GB cada una), manteniendo una precisión estándar de 16 bits (FP16 o BF16). Esto simplifica la arquitectura al evitar cuellos de botella por interconexión externa.
Llama 3.1 405B: Necesidad de clústeres distribuidos
Ejecutar 405B parámetros a 16 bits requiere más de 800 GB de VRAM únicamente para almacenar los pesos del modelo, sin contar el espacio necesario para el contexto de inferencia. Esto obliga a desplegar clústeres multi-nodo enlazados mediante redes de ultra baja latencia como InfiniBand o RoCE. Para operar Llama 3.1 405B dentro de un solo servidor de 8 GPUs H100, los ingenieros deben recurrir forzosamente a cuantizaciones agresivas a 8 bits (FP8) o 4 bits (INT4).
Flujo de decisión de infraestructura física
Comprobar si se dispone de un único servidor GPU (8x H100) o de capacidad de interconexión multi-nodo.
Definir si el caso de uso tolera cuantización FP8/INT4 (indispensable para Llama en nodo simple) o requiere precisión FP16 completa (nativa en Mistral Large 2 en 8x H100).
Estimar la degradación de latencia derivada del paralelismo tensorial y de pipeline entre múltiples máquinas.
El choque de licencias: Meta Community License vs Mistral Research License
Un error común en la industria es asumir que los pesos abiertos equivalen a software de código abierto. Ninguno de estos modelos cumple la definición estricta de la Open Source Initiative (OSI). Ambos corresponden a la categoría open weights bajo condiciones específicas que dictan cómo pueden usarse en el entorno corporativo.
- Llama 3.1 Community License: Meta autoriza el uso comercial sin coste de licencias, siempre y cuando la plataforma receptora no supere los 700 millones de usuarios activos mensuales. Adicionalmente, autoriza de forma explícita el uso de las respuestas del modelo para entrenar, ajustar o destilar otros modelos derivados.
- Mistral Research License (MRL): Mistral AI restringe el acceso público gratuito exclusivamente a investigación académica y usos no comerciales. Cualquier empresa que desee autoalojar Mistral Large 2 para su producto comercial debe contratar una Mistral Commercial License.
Análisis de costes: API gestionada vs cómputo propio
Cuando el autoalojamiento de modelos masivos resulta prohibitivo por la inversión en servidores dedicados, el uso mediante API gestionada se convierte en la vía estándar de despliegue.
En la plataforma oficial de Mistral AI (denominada la Plateforme), Mistral Large 2 cuenta con tarifas de referencia públicas de $2.00 por millón de tokens de entrada y $6.00 por millón de tokens de salida. Esta estructura ofrece acceso a sus 128k tokens de ventana sin incurrir en los costes fijos de mantenimiento de clústeres GPU.
Por su parte, el acceso comercial a Llama 3.1 405B a través de proveedores cloud o nubes de inferencia presenta tarifas variables según el nivel de cuantización ofrecido (FP8 o FP16), obligando a equilibrar el coste por token frente a la pérdida marginal de precisión de las versiones cuantizadas.
Matriz de decisión empresarial: ¿Qué modelo elegir?
- Opta por Mistral Large 2 si: tu equipo busca liderar en tareas de programación (92.0% en HumanEval), dispones de un solo servidor de 8x H100 para FP16 o prefieres consumir una API oficial a $2.00 / $6.00 por millón de tokens.
- Opta por Llama 3.1 405B si: requieres máxima precisión en razonamiento matemático (96.8% en GSM8K), planeas destilar modelos más pequeños para uso interno o cuentas con infraestructura de clúster multi-nodo para inferencia masiva.
Veredicto Eduky: Mistral Large 2 gana en densidad de eficiencia técnica para empresas de ingeniería que buscan código de alto nivel y despliegues mononodo controlados. Llama 3.1 405B sigue siendo la cumbre del razonamiento abierto puro y la mejor herramienta de destilación de conocimiento, siempre que se cuente con la infraestructura necesaria para sostener su escala.
🚀 ¿Quieres estar siempre actualizado en IA?
Únete a nuestra comunidad donde compartimos noticias, herramientas, guías y oportunidades sobre inteligencia artificial.
Preguntas frecuentes
¿Son Llama 3.1 405B y Mistral Large 2 modelos de código abierto?
Técnicamente no. Ambos son modelos de pesos abiertos (open weights). No cumplen los estándares oficiales de código abierto debido a restricciones de licencia: Meta limita el uso a plataformas de menos de 700 millones de usuarios y Mistral condiciona el uso gratuito a la investigación no comercial.
¿Puedo usar las respuestas de Llama 3.1 405B para entrenar mi propio LLM?
Sí. La licencia de Meta Llama 3.1 permite explícitamente emplear sus datos de salida para la destilación, ajuste fino y entrenamiento de otros modelos de inteligencia artificial.
¿Por qué Mistral Large 2 es más fácil de autoalojar que Llama 3.1 405B?
Debido a que sus 123 mil millones de parámetros permiten cargarlo en precisión FP16/BF16 en un único nodo de 8 GPUs Nvidia H100 (80GB). En cambio, Llama 3.1 405B a 16 bits excede los 800 GB y necesita múltiples servidores interconectados por redes de alta velocidad.
Fuentes consultadas
🔥 Sigue Eduky Blog para más contenido sobre IA
Noticias, herramientas, automatizaciones y guías prácticas para mantenerte siempre al día.

Publicar comentario