Meta lanza Muse Spark Open: arquitectura MoE de 816B, soporte para Apple M5 Ultra y salto en flujos agénticos
Meta lanza Muse Spark Open: arquitectura MoE de 816B, soporte para Apple M5 Ultra y salto en flujos agénticos
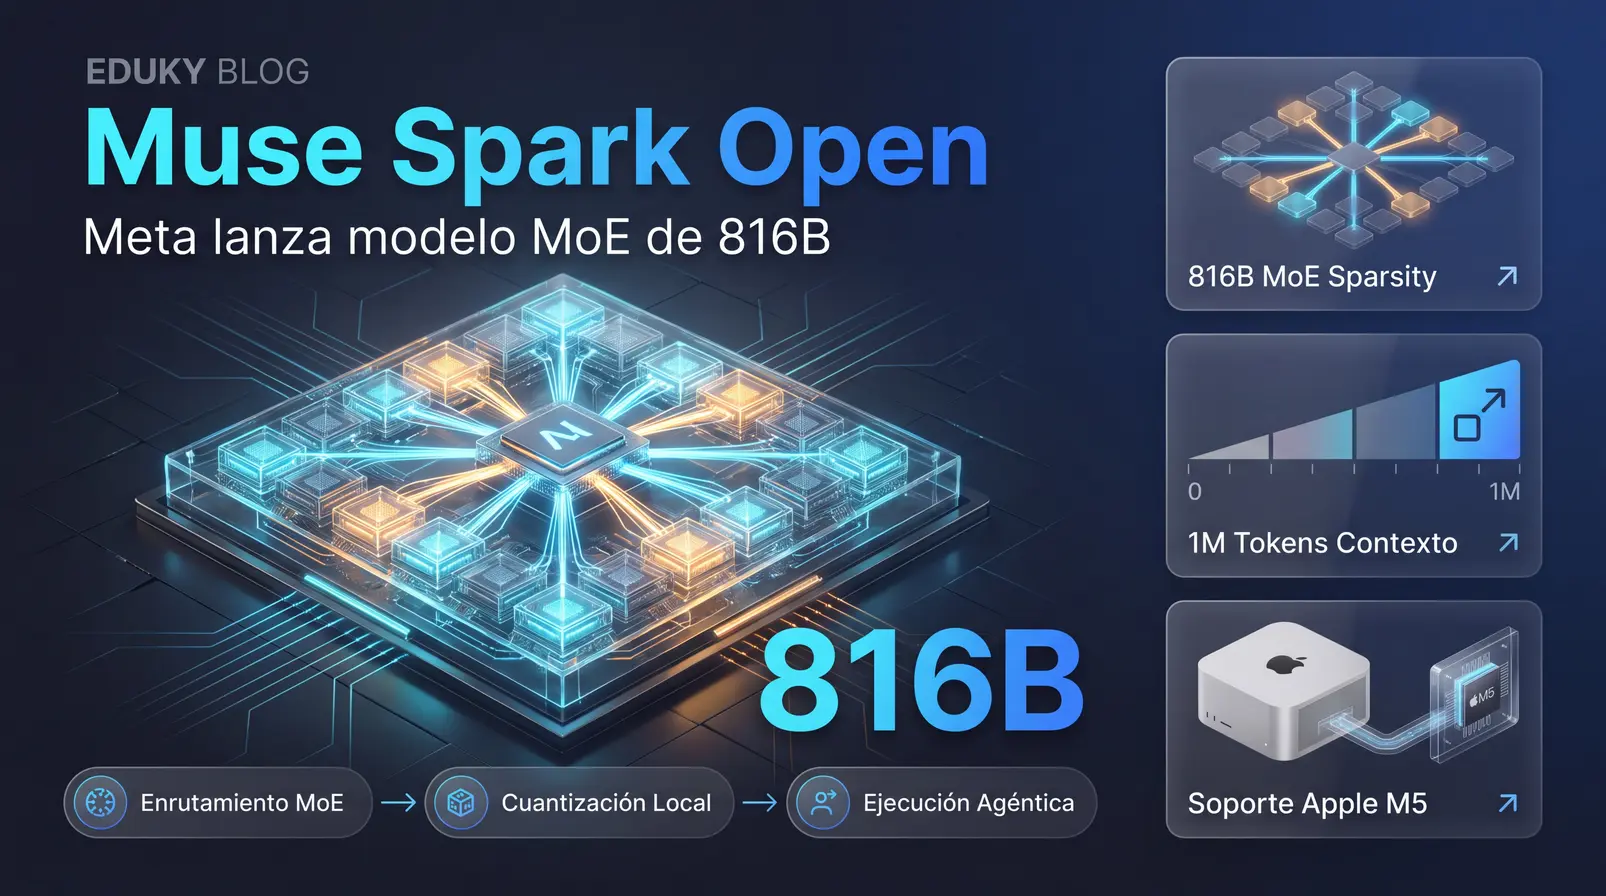
Meta Superintelligence Labs presenta Muse Spark Open, un modelo de 816B con contexto de 1M de tokens, soporte multimodal y ejecución en silicio Apple M5 Ultra.
Muse Spark Open marca el inicio de una nueva etapa estratégica para Meta Superintelligence Labs: un modelo multimodal nativo de pesos abiertos con arquitectura Sparse Mixture-of-Experts (MoE) que alcanza los 816 mil millones de parámetros totales. Diseñado específicamente para afrontar tareas complejas de ingeniería de software, razonamiento extendido y control autónomo de herramientas, el sistema introduce una ventana de contexto de 1 millón de tokens y compatibilidad directa con hardware de última generación como los chips Apple M5 Ultra.
Puntos clave del lanzamiento
- Escala MoE de 816B: Cuenta con 816 mil millones de parámetros totales, activando únicamente cerca de 42 mil millones (42.7B) por cada token procesado.
- Ventana contextual masiva: Procesa hasta 1,048,576 tokens (1M) combinando entradas de texto, audio, imagen y video con generación de respuestas en texto.
- Rendimiento en herramientas: Registra 89.2 puntos en el benchmark de invocación de herramientas MCP-Atlas y 61.8 en JobBench.
- Despliegue local avanzado: Optimizado para silicio unificado de Apple con MLX (capaz de correr en configuraciones de 2x Mac Studio con M5 Ultra) y librerías abiertas como llama.cpp, Unsloth, vLLM y SGLang.
- Distribución comunitaria: Publicado bajo los términos de la Muse Model License en Hugging Face en formatos BF16 y NVFP4.
Parámetros totales MoE
Parámetros activos por token
Tokens de ventana de contexto
Puntaje en MCP-Atlas (Tool Use)
Arquitectura MoE 816B/42B: eficiencia sparse y contexto masivo
El núcleo técnico tras el desarrollo de Muse Spark Open reside en su diseño Sparse Mixture-of-Experts. En lugar de activar toda su estructura neuronal en cada inferencia, el sistema reparte el cómputo en 256 expertos especializados a nivel de capas, seleccionando de forma dinámica únicamente 8 expertos por token. Esta técnica permite que un gigante de 816B compute con el costo y la latencia equivalente a un modelo denso de aproximadamente 42 mil millones de parámetros.
Esta arquitectura se complementa con una ventana de contexto nativa de un millón de tokens. En la práctica, esto permite a desarrolladores e investigadores introducir repositorios de software completos, historiales de ejecución prolongados o secuencias extensas de video y audio sin necesidad de fragmentar la información ni perder consistencia lógica en sesiones largas de trabajo.
Capacidades agénticas y multimodales: evaluación en código y herramientas
A diferencia de iteraciones previas más generalistas, este modelo pone el foco en flujos agénticos donde la IA debe interactuar directamente con entornos informáticos, APIs y terminales operativas. Al admitir entradas combinadas de texto, imágenes, audio y video, el sistema puede inspeccionar capturas de pantalla, diagramas de arquitectura técnica y mensajes de error antes de redactar código o invocar una función.
La siguiente tabla sitúa el desempeño reportado frente a otros sistemas punteros del ecosistema internacional de modelos abiertos y de pesos abiertos:
| Modelo | Tipo de Pesos | MCP-Atlas (Tool Use) | Terminal-Bench 2.1 |
|---|---|---|---|
| Muse Spark Open | Abiertos (Muse License) | 89.2 | 76.4% |
| Kimi K3 | Abiertos | Competitivo | 85.0% |
| GLM 5.3 | Abiertos | Competitivo | 83.9% |
Aunque la propuesta de Meta lidera con solidez en la gestión orquestada de herramientas, en tareas específicas y confinadas a la línea de comandos pura (Terminal-Bench 2.1, donde logra 76.4%), alternativas punteras como Kimi K3 (85.0%) y GLM 5.3 (83.9%) conservan un margen favorable.
El reto del hardware: ejecución en Apple M5 Ultra y ecosistema local
La publicación de un modelo de 816 mil millones de parámetros plantea de inmediato el desafío de los recursos de cómputo. En precisión original de 16 bits (BF16), los pesos del modelo ocupan aproximadamente 1.63 TB de espacio en disco antes del overhead operativo de memoria, lo que habitualmente restringe su ejecución a clusters profesionales de centros de datos.
Para mitigar esta barrera en estaciones de trabajo avanzadas, Meta Superintelligence Labs y la comunidad de código abierto coordinaron optimizaciones dirigidas a silicio comercial con memoria unificada masiva:
A través del framework MLX de Apple, se validó la ejecución paralela distribuida en dos estaciones Mac Studio equipadas con procesadores M5 Ultra, combinando 1 TB de memoria unificada para sostener la inferencia local sin clústeres externos.
Mediante esquemas de cuantización a 2 bits (como UD-IQ2_XXS en llama.cpp), la huella de memoria se reduce a una franja de entre 250 y 316 GB de RAM, permitiendo su carga en hardware de escritorio de gama muy alta.
Soporte oficial y nativo para formatos comprimidos NVFP4 junto con frameworks de inferencia de alto rendimiento como vLLM y SGLang.
Licencia Muse Model License y panorama geopolítico de los pesos abiertos
La distribución de Muse Spark Open se formalizó a través de Hugging Face bajo la denominada Muse Model License. Es fundamental distinguir este esquema de las licencias de código abierto convencionales avaladas por la Open Source Initiative (OSI). Tal como ocurrió con las familias anteriores de Meta, se trata de una distribución open-weight con condiciones comunitarias específicas, que impone requerimientos explícitos de aceptación de términos y restricciones en volúmenes comerciales masivos.
El movimiento cobra relevancia geopolítica en un contexto donde los desarrollos de pesos abiertos procedentes de laboratorios asiáticos (como las series Qwen, GLM y Kimi) han liderado con frecuencia las tablas de rendimiento global. Con este lanzamiento fechado el 15 de octubre de 2026, Meta busca consolidar la posición de la industria estadounidense en la oferta de pesos abiertos de gran escala para entornos de producción y privacidad local.
🚀 ¿Quieres estar siempre actualizado en IA?
Únete a nuestra comunidad donde compartimos noticias, herramientas, guías y oportunidades sobre inteligencia artificial.
Preguntas frecuentes
¿Es Muse Spark Open completamente open source?
Se distribuye bajo el formato open-weight con la licencia propietaria Muse Model License. Aunque sus pesos son descargables públicamente en Hugging Face, incluye términos de uso y restricciones comerciales que difieren del código abierto tradicional bajo estándares OSI.
¿Qué hardware mínimo se necesita para correrlo en local?
Incluso con técnicas de compresión agresivas a 2 bits (GGUF), se requieren entre 250 y 316 GB de memoria combinada. Para precisión completa o formatos poco degradados (BF16), el peso en disco supera 1.6 TB y requiere configuraciones como 1 TB de memoria unificada en dos Mac Studio M5 Ultra o infraestructura de múltiples aceleradores de centro de datos.
¿Qué tipos de datos puede procesar el modelo?
Es un modelo multimodal nativo: admite entradas en texto, imagen, video y audio, procesando consultas de hasta 1 millón de tokens para entregar respuestas estructuradas en texto.
Fuentes consultadas
🔥 Sigue Eduky Blog para más contenido sobre IA
Noticias, herramientas, automatizaciones y guías prácticas para mantenerte siempre al día.

Publicar comentario