Tutorial n8n: Cómo crear un Agente Autónomo de IA con memoria y herramientas sin programar
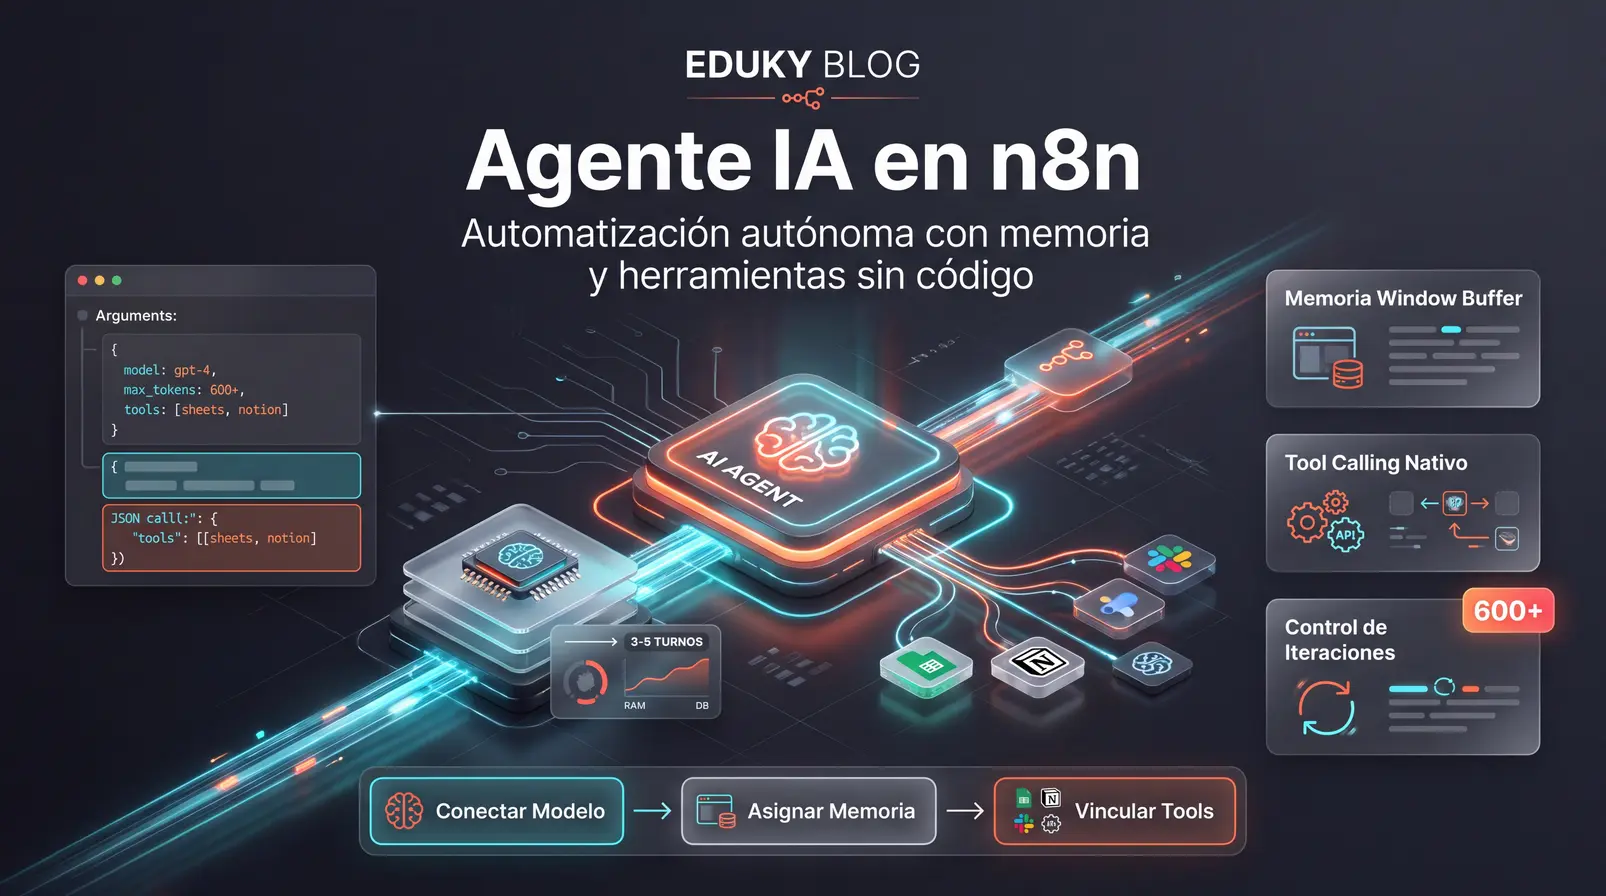
Tutorial n8n: Cómo crear un Agente Autónomo de IA con memoria y herramientas sin programar
Aprende a estructurar un agente autónomo en n8n combinando modelos LLM, memoria conversacional y herramientas como Google Sheets o Notion sin escribir código.
Claves del tutorial
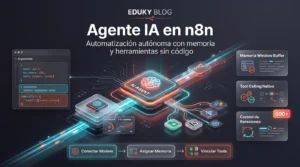
- Aprenderás a construir un agente autónomo conectando el nodo AI Agent con modelos de lenguaje, memoria y herramientas en n8n.
- Descubrirás cómo configurar la retención contextual mediante Simple Memory (Buffer Window) y cuándo migrar a Redis o Postgres.
- Entenderás cómo transformar integraciones nativas como Google Sheets o Notion en herramientas ejecutables por el modelo.
- Aprenderás a depurar errores de sintaxis y a limitar iteraciones para impedir bucles infinitos y sobrecostes de tokens.
Configurar un flujo conversacional básico ya no es suficiente cuando los flujos de trabajo profesionales exigen consultar bases de datos, actualizar registros y tomar decisiones contextuales sobre la marcha. En este tutorial n8n ai agent, aprenderás paso a paso cómo estructurar un agente autonomo sin programar capaz de recordar el hilo de la conversación y ejecutar acciones reales en aplicaciones de terceros mediante llamadas a funciones.
Qué es el nodo AI Agent en n8n y cómo funciona su arquitectura
A diferencia de una simple llamada a una API de chat, el nodo AI Agent actúa como un orquestador centralizado basado en LangChain dentro de n8n. Este nodo evalúa los mensajes entrantes, razona sobre el objetivo del usuario y decide de forma autónoma si debe responder directamente o ejecutar una o varias herramientas externas.
Para que esta arquitectura modular opere, el nodo AI Agent se nutre de cuatro subnodos interconectados:
- Disparador (Trigger / Webhook): Punto de entrada del mensaje (como un webhook, interfaz de chat, Telegram o WhatsApp).
- Chat Model: El cerebro del sistema, soportado por modelos como OpenAI (GPT), Anthropic (Claude) o Google Gemini.
- Memory: El componente que almacena y recupera el histórico de la conversación.
- Tools: Nodos de acción y consulta que el agente invoca dinámicamente según la necesidad.
Requisitos previos
Antes de comenzar con la implementación técnica en n8n, asegúrate de contar con lo siguiente:
- Una instancia activa de n8n (versión Cloud o Self-Hosted).
- Credenciales y claves de API activas con saldo disponible en tu proveedor preferido (OpenAI, Anthropic Claude o Google Gemini).
- Cuentas conectadas con permisos de lectura y escritura en los servicios que usarás como herramientas (por ejemplo, Google Sheets o Notion).
Configuración de la retención contextual: Simple Memory vs. producción
Un agente conversacional pierde su utilidad si olvida las instrucciones previas en el siguiente turno. El manejo de la memoria define directamente la calidad de la respuesta y la factura de la API.
Si fijas el valor en 5 turnos, el sistema inyectará automáticamente los 10 mensajes previos en el prompt de entrada de cada nueva petición. Un valor de 3 a 5 turnos suele ser el equilibrio ideal para mantener coherencia sin inflar la latencia ni agotar el presupuesto de tokens.
| Tipo de memoria | Almacenamiento | Persistencia | Escenario recomendado |
|---|---|---|---|
| Simple Memory (Buffer Window) | Memoria RAM del proceso worker | Volátil (se borra al reiniciar o con múltiples workers) | Pruebas locales, prototipado y entornos con un solo worker |
| Redis / Postgres Chat Memory | Base de datos externa persistente | Permanente e independiente del ciclo de vida del contenedor | Producción real y despliegues con queue mode |
Paso a paso para crear un agente de IA en n8n con herramientas
Añade el nodo AI Agent al lienzo. Conecta al puerto de entrada un Chat Trigger o Webhook. En el puerto Model, vincula el nodo de tu proveedor (OpenAI, Anthropic o Google Gemini) configurando tus credenciales de API activas.
Añade el subnodo Window Buffer Memory (Simple Memory) y conéctalo al puerto Memory del agente. Ajusta el parámetro Context Window Length entre 3 y 5 turnos y vincula la Session Key correspondiente.
Localiza la integración estándar que necesites, como Google Sheets (operación Append row) o Notion (operación Create page), y conéctala directamente al puerto Tool del nodo AI Agent.
En cada herramienta conectada, completa de forma clara el nombre y la descripción de la Tool. Explica con exactitud qué hace la herramienta y qué datos espera recibir en cada argumento.
Establece el parámetro Max Iterations entre 10 y 20 para evitar llamadas recursivas y ejecuta pruebas desde la interfaz de chat de n8n para validar la respuesta y el almacenamiento.
Ingeniería de descripciones para Tools: cómo evitar alucinaciones
El modelo no ejecuta código visual por arte de magia; recurre al mecanismo de tool calling nativo del LLM. Para determinar cuándo y cómo invocar un nodo, el agente lee únicamente dos elementos: el nombre del subnodo Tool y su descripción en lenguaje natural.
“Usa esto para guardar notas.” — Provoca que el modelo alucine columnas inexistentes o envíe tipos de datos incompatibles.
Ejemplo de descripción optimizada:
“Úsala para registrar un nuevo lead cuando el usuario proporcione su nombre y correo. Requiere los campos exactos: ‘nombre’ (texto) y ‘email’ (correo válido). No la ejecutes si falta el correo.”
Las descripciones imprecisas provocan errores comunes de parsing, donde el LLM devuelve un formato JSON defectuoso o asigna variables al parámetro equivocado.
Depuración y optimización del agente en n8n
Cuando un agente no responde como se espera, la causa suele encontrarse en el ciclo de razonamiento del modelo. Para auditar su comportamiento, n8n proporciona herramientas de diagnóstico específicas:
- Inspección del Execution Log: Revisa cada paso de la llamada intermedia para verificar qué argumentos exactos generó el LLM antes de ejecutar la Tool y cuál fue la respuesta devuelta por la API externa.
- Prevención de loops infinitos: Si el agente no obtiene la información exacta que busca, puede intentar llamar a la misma herramienta una y otra vez. Configurar el límite de Max Iterations en un rango de 10 a 20 iteraciones detiene la ejecución antes de que el proceso agote tu saldo.
- Impacto en costes y latencia: Recuerda que cada turno retenido en el buffer de memoria y cada herramienta disponible aumentan el tamaño del prompt del sistema. Un agente con 5 herramientas y un buffer largo procesará miles de tokens de entrada adicionales en cada respuesta, incrementando tanto el tiempo de espera como el coste de facturación.
Checklist de verificación antes de pasar a producción
- [ ] Credenciales del modelo de lenguaje configuradas con saldo y límites de cuota vigentes.
- [ ] Buffer de memoria configurado entre 3 y 5 turnos de intercambio.
- [ ] Session Key dinámico configurado para aislar historiales entre diferentes usuarios.
- [ ] Memoria persistente (Redis o Postgres) activada si la instancia escala en queue mode o múltiples workers.
- [ ] Descripciones operativas de cada Tool redactadas con nombres de campos y tipos de datos obligatorios.
- [ ] Parámetro Max Iterations limitado entre 10 y 20 iteraciones para salvaguardar el flujo.
- [ ] Verificación de argumentos y respuestas en el Execution Log completada.
🚀 ¿Quieres estar siempre actualizado en IA?
Únete a nuestra comunidad donde compartimos noticias, herramientas, guías y oportunidades sobre inteligencia artificial.
Preguntas frecuentes
¿Por qué mi agente olvida los datos al reiniciar el servidor de n8n?
Esto ocurre porque estás utilizando Simple Memory (Window Buffer), la cual guarda el historial conversacional en la memoria RAM del proceso worker. Para retener datos de forma indefinida tras un reinicio, debes cambiar al nodo Postgres Chat Memory o Redis Chat Memory.
¿Qué sucede si dejo el parámetro Session Key en blanco en el nodo de memoria?
Si no vinculas un identificador único (como el chat_id de Telegram o el ID de usuario del Webhook), el agente utilizará un contexto global predeterminado, mezclando las respuestas e historiales de diferentes personas.
¿Cómo evito que el agente caiga en un bucle repetitivo de llamadas a herramientas?
Debes definir el valor de Max Iterations dentro del nodo AI Agent (generalmente entre 10 y 20 pasos) y refinar la descripción textual del nodo Tool para que el LLM sepa con certeza cuándo se ha completado la tarea.
Fuentes consultadas
🔥 Sigue Eduky Blog para más contenido sobre IA
Noticias, herramientas, automatizaciones y guías prácticas para mantenerte siempre al día.

Publicar comentario