Guía unificada de Prompt Engineering 2026: comparativa OpenAI, Anthropic y Google
Guía unificada de Prompt Engineering 2026: comparativa OpenAI, Anthropic y Google
Descubre las directrices oficiales de prompt engineering de OpenAI, Anthropic y Google: sintaxis XML vs. Markdown, instrucciones afirmativas y defensas anti-inyección.
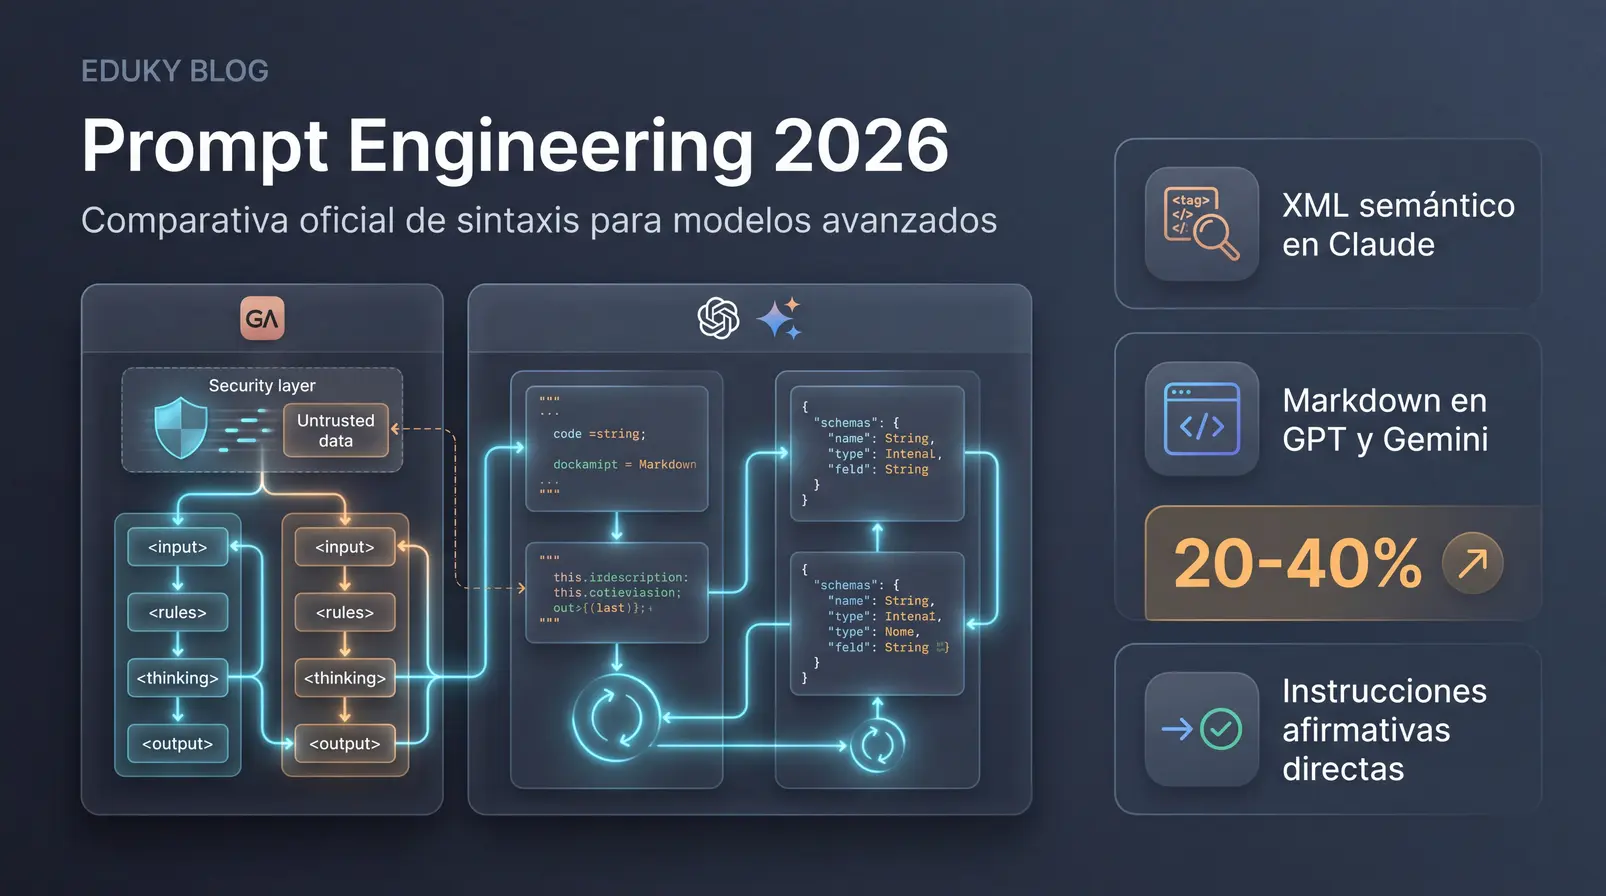
El ecosistema de la inteligencia artificial ha madurado y, con él, la disciplina del prompt engineering 2026 ha dejado atrás los trucos improvisados para consolidarse en especificaciones técnicas formales. Aunque los modelos de lenguaje modernos procesan lenguaje natural con asombrosa soltura, los manuales de ingeniería de OpenAI, Anthropic y Google demuestran que la sintaxis elegida altera de forma directa la fiabilidad y la precisión de las respuestas.
Claves del análisis comparativo
- Convergencia en lógica afirmativa: Los tres gigantes coinciden en sustituir prohibiciones (“qué no hacer”) por mandatos directos y constructivos (“qué hacer”).
- Divergencia estructural: Anthropic estandariza etiquetas XML semánticas para Claude; OpenAI y Google priorizan jerarquías Markdown combinadas con bloques delimitados.
- Aislamiento de seguridad: El encapsulado estricto de datos no confiables reduce el riesgo de inyecciones de prompts en agentes y flujos automatizados.
- Nuevas reglas en modelos de razonamiento: Los prompts paso a paso o ‘chain-of-thought’ manuales se desaconsejan en arquitecturas autorreflexivas avanzadas.
Proveedores oficiales analizados
Mejora en consistencia en Claude mediante XML
Pilares estructurales compartidos en 2026
Los 4 pilares estructurales compartidos en prompt engineering 2026
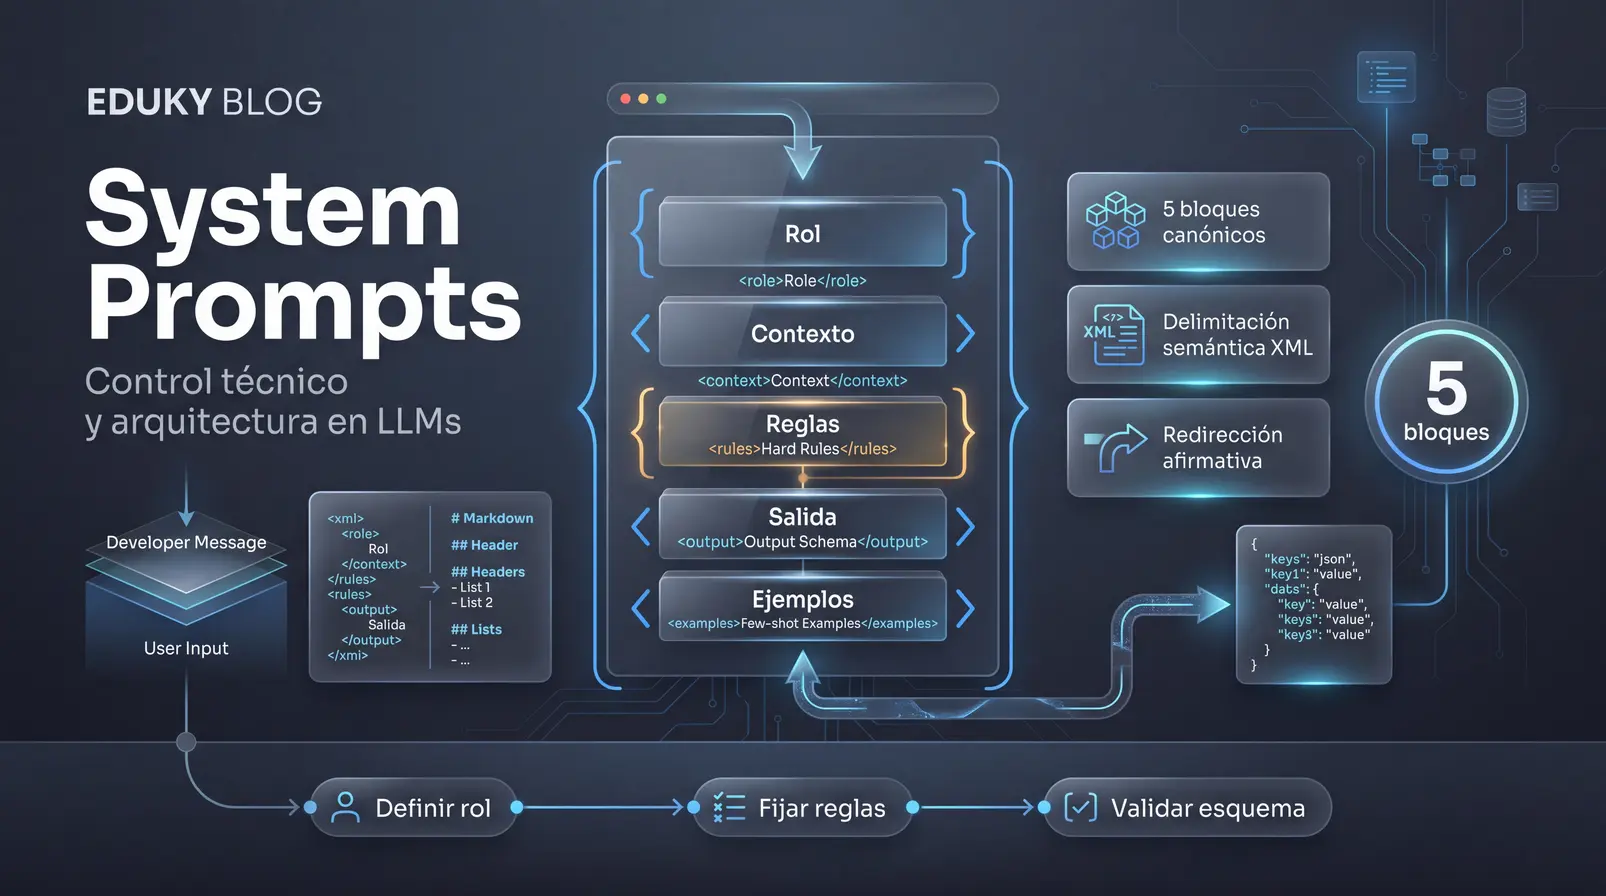
Independientemente de la plataforma seleccionada, la documentación oficial coincide en que un prompt robusto debe desacoplar claramente sus componentes mediante una arquitectura modular de cuatro bloques:
Establece la perspectiva operativa y el nivel de competencia desde el que debe responder el modelo.
Aporta los datos, restricciones del entorno o antecedentes requeridos para contextualizar la tarea.
Define la acción concreta y no ambigua que el modelo debe ejecutar sobre el contexto suministrado.
Fija el formato exacto de respuesta (JSON, Markdown, tabla o lista estructurada) esperado por el usuario.
Batalla de sintaxis: XML semántico vs. Jerarquía Markdown
La principal discrepancia técnica entre proveedores radica en cómo los modelos interpretan las fronteras entre instrucciones y datos. Esta elección influye en la capacidad de parseo y en la consistencia de salida.
Anthropic y la primacía de las etiquetas XML
Anthropic documenta el uso de etiquetas XML personalizadas (como <context>, <instructions> y <output_format>) como su estándar de primer nivel para Claude. Este diseño responde a cuatro ventajas documentadas:
- Claridad en los límites: El modelo distingue sin ambigüedad dónde terminan las órdenes del sistema y dónde comienzan los datos auxiliares.
- Precisión operativa: Permite referenciar bloques exactos en instrucciones posteriores (por ejemplo: “Analiza únicamente el texto dentro de
<documents>“). - Flexibilidad estructural: Admite jerarquías anidadas complejas sin colisionar con formatos de texto plano.
- Facilidad de extracción (parseability): Permite instruir a Claude a encapsular su respuesta dentro de etiquetas específicas (
<response>), agilizando su captura mediante código.
En pruebas documentadas para Claude, la estructuración mediante etiquetas XML en contextos extensos aporta una mejora de entre el 20% y el 40% en la consistencia del seguimiento de instrucciones.
OpenAI y Google Gemini: Estructura Markdown y comillas triples
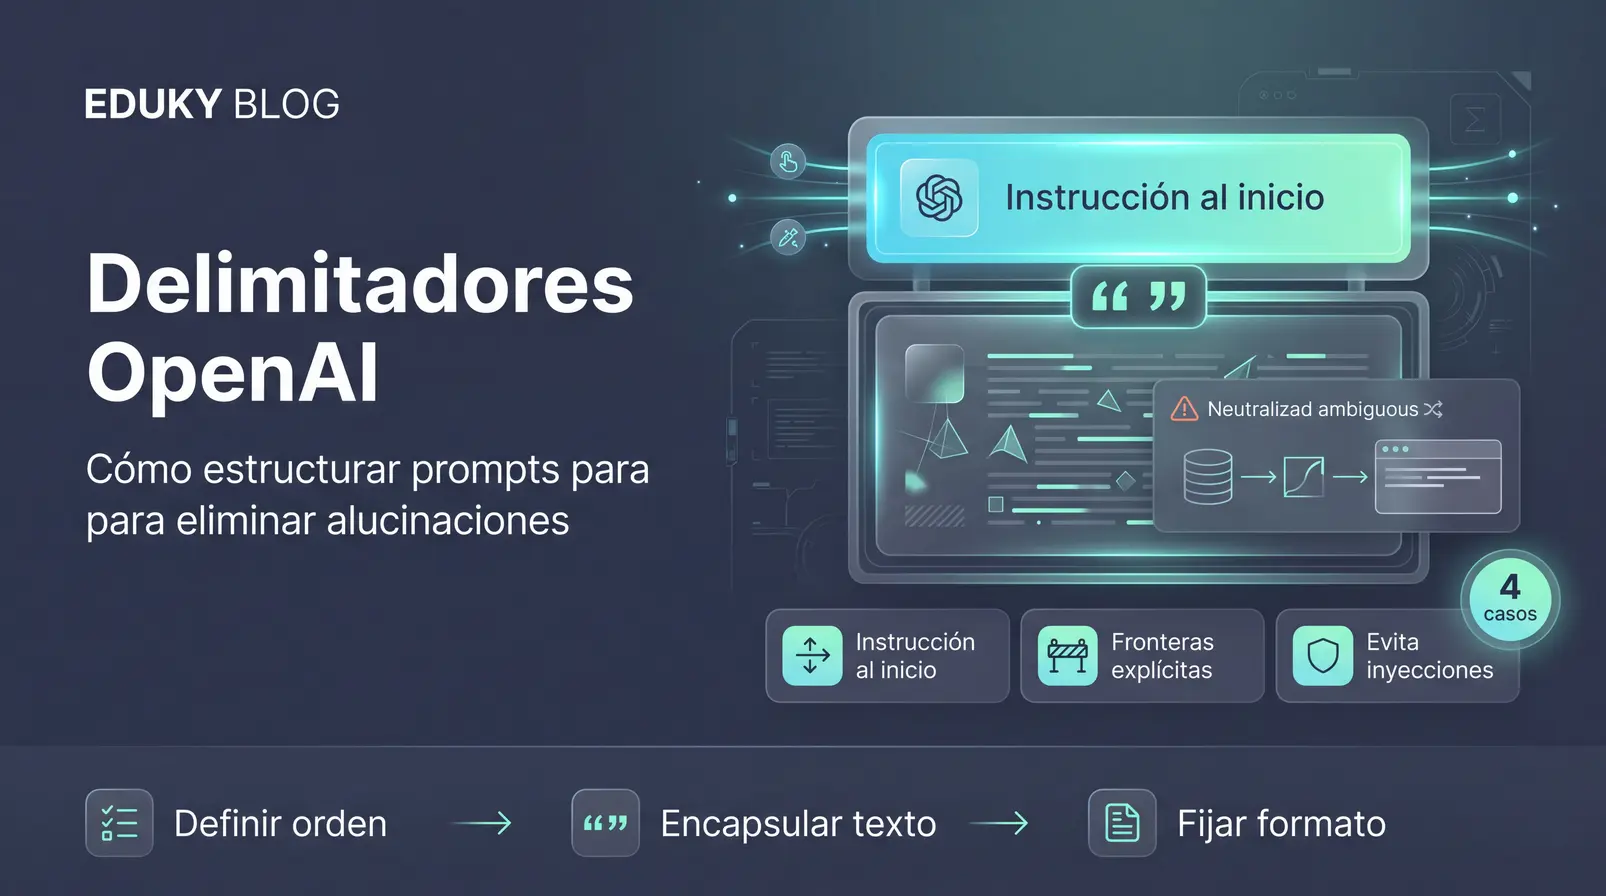
OpenAI y Google recomiendan primariamente encabezados Markdown (##), listas estructuradas y delimitadores como comillas triples (""") o bloques de código para segmentar la información en ChatGPT y Gemini. No obstante, OpenAI también valida el etiquetado XML para aislar contenido externo sensible en arquitecturas basadas en API.
| Criterio Técnico | OpenAI (ChatGPT / o-series) | Anthropic (Claude) | Google (Gemini) |
|---|---|---|---|
| Sintaxis recomendada | Markdown (##, listas) y comillas triples (“””) | Etiquetas XML semánticas (<tag></tag>) | Markdown (##), directivas concisas y esquemas tipados |
| Delimitación de datos | Bloques de código o etiquetas XML secundarias | Contenedores XML dedicados (<data>, <context>) | Encabezados Markdown y esquemas estructurados |
| Modelos de razonamiento | Evitar pasos ‘chain-of-thought’ manuales preformateados | Instrucciones claras y directas sin sobrecargar pasos | Evitar formatear razonamientos (‘thinking’ nativo) |
Mitigación de alucinaciones: La regla universal del ‘Qué hacer’
A pesar de sus diferencias sintácticas, OpenAI, Anthropic y Google coinciden unánimemente en un principio de formulación: las restricciones deben definirse mediante instrucciones afirmativas y directas en lugar de negativas puras.
Cuando un prompt incluye instrucciones prohibitivas como “No seas excesivamente formal” o “No incluyas explicaciones innecesarias”, el modelo se ve forzado a conjeturar cuál es la alternativa deseada, aumentando la variabilidad y el riesgo de desviaciones. En contraste, dictar el comportamiento esperado de forma positiva (por ejemplo: “Responde en tono conversacional y limita tu salida a un resumen de tres puntos clave”) delimita con precisión el espacio probabilístico de generación.
Arquitectura anti-inyección: Delimitación de datos no confiables
En el despliegue de asistentes y agentes que consumen datos externos (correos, páginas web o entradas de formularios), el riesgo de prompt injection es crítico. Si un usuario malintencionado introduce instrucciones dentro de un campo de texto, el modelo podría confundir ese texto con órdenes directas del sistema.
Las directrices de OpenAI e investigaciones del sector confirman que encapsular los datos no confiables en bloques separados (dentro de mensajes con rol de usuario o delimitados estrictamente con etiquetas semánticas) previene eficazmente que estas entradas sobreescriban las directivas maestras.
El cambio de paradigma en modelos de razonamiento
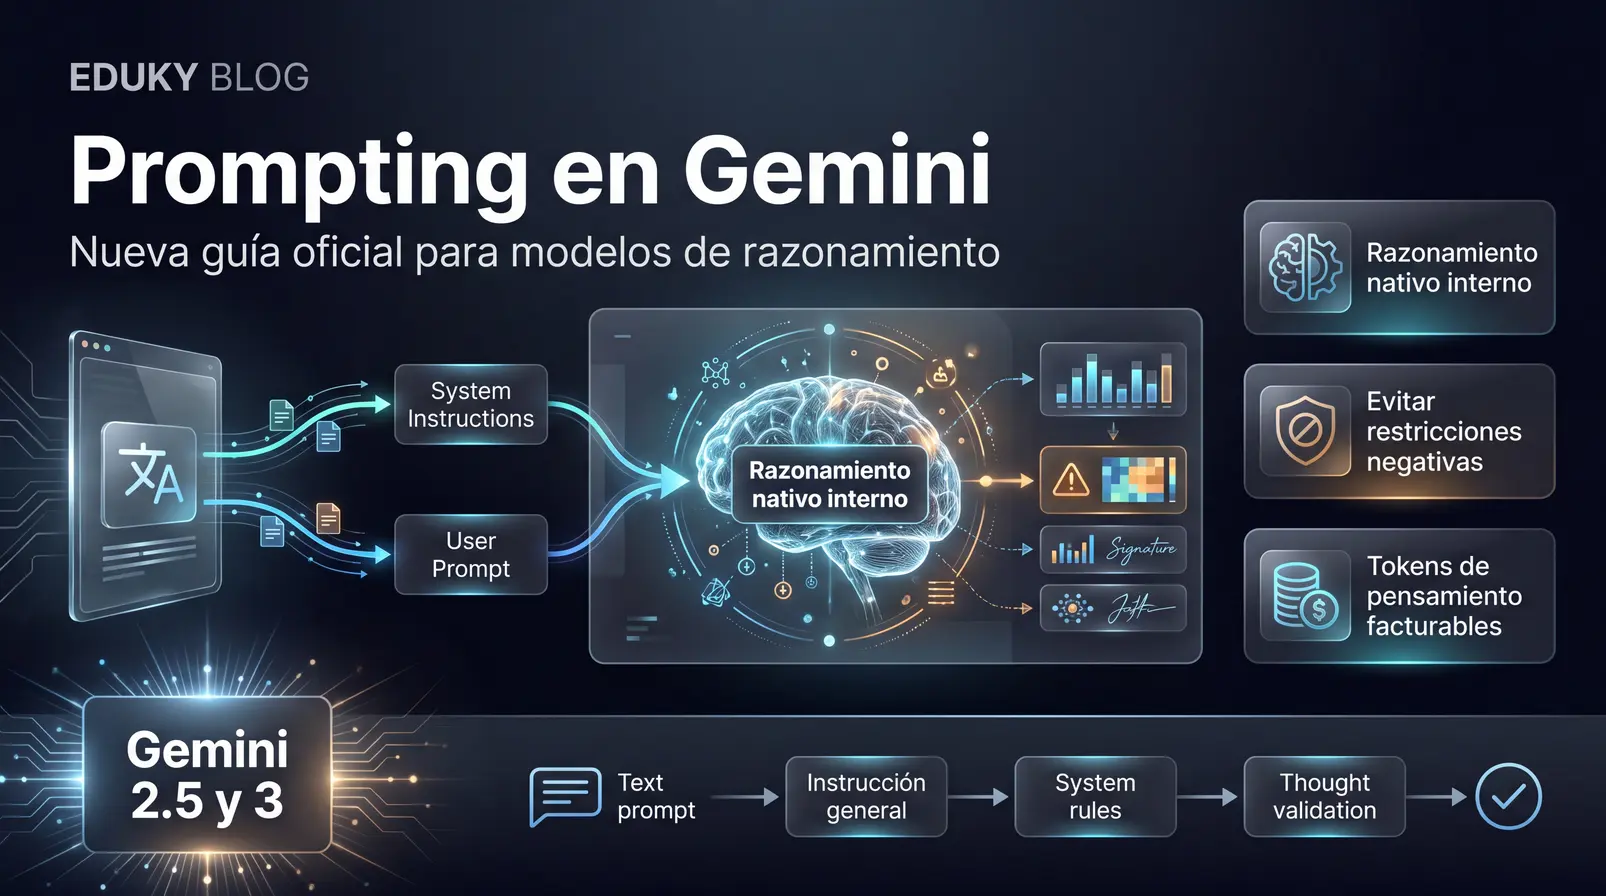
Durante años, la técnica más repetida en prompt engineering fue inducir al modelo a “pensar paso a paso” mediante estructuras preformateadas de razonamiento en cadena (Chain-of-Thought). Con la llegada de arquitecturas orientadas al razonamiento autorreflexivo nativo —como la serie OpenAI o-series y los modelos Gemini con ‘thinking’ extendido—, las guías oficiales desaconsejan explícitamente forzar estos esquemas manuales.
Imponer pasos intermedios rígidos en el prompt interfiere con los mecanismos internos de autorreflexión del modelo. En estas arquitecturas, la recomendación oficial consiste en definir la meta final y los criterios de evaluación, permitiendo que el motor de inferencia asigne internamente los tokens de razonamiento necesarios.
Plantillas prácticas adaptadas por ecosistema
A continuación se presentan dos plantillas oficiales optimizadas para aplicar la sintaxis idónea según el entorno en el que trabajes.
Plantilla optimizada para Claude (Sintaxis XML)
Esta estructura aprovecha las ventajas de separación y extracción de Anthropic:
<system_instructions>
Eres un analista de datos sénior. Tu función es resumir informes técnicos con enfoque empresarial.
</system_instructions>

<context>
El informe adjunto corresponde a métricas de rendimiento del último trimestre fiscal.
</context>

<user_data>
[Inserta aquí los datos externos o no confiables]
</user_data>

<task>
Extrae los tres principales hallazgos del contenido en <user_data>. Redacta cada punto en un máximo de dos oraciones afirmativas.
</task>

<output_format>
Entrega el resultado exclusivamente dentro de etiquetas <summary>.
</output_format>
Plantilla optimizada para OpenAI y Gemini (Markdown estructurado)
Esta variante utiliza la jerarquía de encabezados y delimitadores recomendada para ChatGPT y Gemini:
## Rol y Objetivo
Actúa como un especialista en comunicación técnica. Convierte notas desordenadas en directivas de acción claras.

## Contexto y Restricciones
- Mantén un tono formal y asertivo.
- Cada elemento debe describir una tarea concreta a ejecutar.

## Información de Entrada
"""
[Inserta aquí el texto o datos a procesar]
"""

## Tarea
Organiza la información anterior en una lista numerada de acciones prioritarias. Finaliza con una tabla resumen que especifique: Tarea y Responsable sugerido.
En conclusión
A medida que los modelos multimodales y de razonamiento evolucionan, la hipersensibilidad a detalles sintácticos mínimos disminuye progresivamente. Sin embargo, dominar la delimitación precisa (XML para Claude, Markdown para GPT y Gemini) y erradicar las órdenes negativas siguen siendo los factores decisivos para lograr sistemas consistentes, seguros y libres de alucinaciones.
Preguntas frecuentes
¿Es obligatorio usar XML al interactuar con Claude?
No es obligatorio, pero Anthropic lo documenta como el estándar óptimo. En prompts extensos o complejos, el uso de etiquetas XML genera entre un 20% y un 40% de mejora en la consistencia del seguimiento de instrucciones.
¿Por qué no se aconseja usar directivas negativas como ‘No inventes nada’?
OpenAI, Anthropic y Google señalan que las negaciones obligan al modelo a interpretar la alternativa válida, lo que eleva la variabilidad. Es más efectivo indicar explícitamente la directiva afirmativa: “Responde únicamente basándote en la información provista; si el dato no aparece, indica ‘No disponible'”.
¿Los delimitadores semánticos garantizan inmunidad frente a inyecciones de prompt?
No son barreras infalibles. Aunque aíslan de forma efectiva el contexto en la mayoría de los casos de uso, en aplicaciones de producción deben complementarse con validación de entradas y aislamiento estricto de privilegios.
🚀 ¿Quieres estar siempre actualizado en IA?
Únete a nuestra comunidad donde compartimos noticias, herramientas, guías y oportunidades sobre inteligencia artificial.
Fuentes consultadas
🔥 Sigue Eduky Blog para más contenido sobre IA
Noticias, herramientas, automatizaciones y guías prácticas para mantenerte siempre al día.

Publicar comentario