RAG vs Fine-Tuning: Guía de arquitectura y marco de decisión para proyectos de IA
RAG vs Fine-Tuning: Guía de arquitectura y marco de decisión para proyectos de IA
Aprende las diferencias reales entre RAG y Fine-Tuning, cuándo aplicar cada enfoque y cómo elegir la arquitectura adecuada para tus aplicaciones de IA.
Elegir entre rag vs fine tuning se ha convertido en una de las decisiones arquitectónicas más determinantes al implementar modelos de lenguaje en producción. Una elección equivocada en esta etapa no solo incrementa la factura de infraestructura, sino que puede comprometer la fiabilidad y la gobernanza de datos de todo el sistema.
Claves del marco de decisión
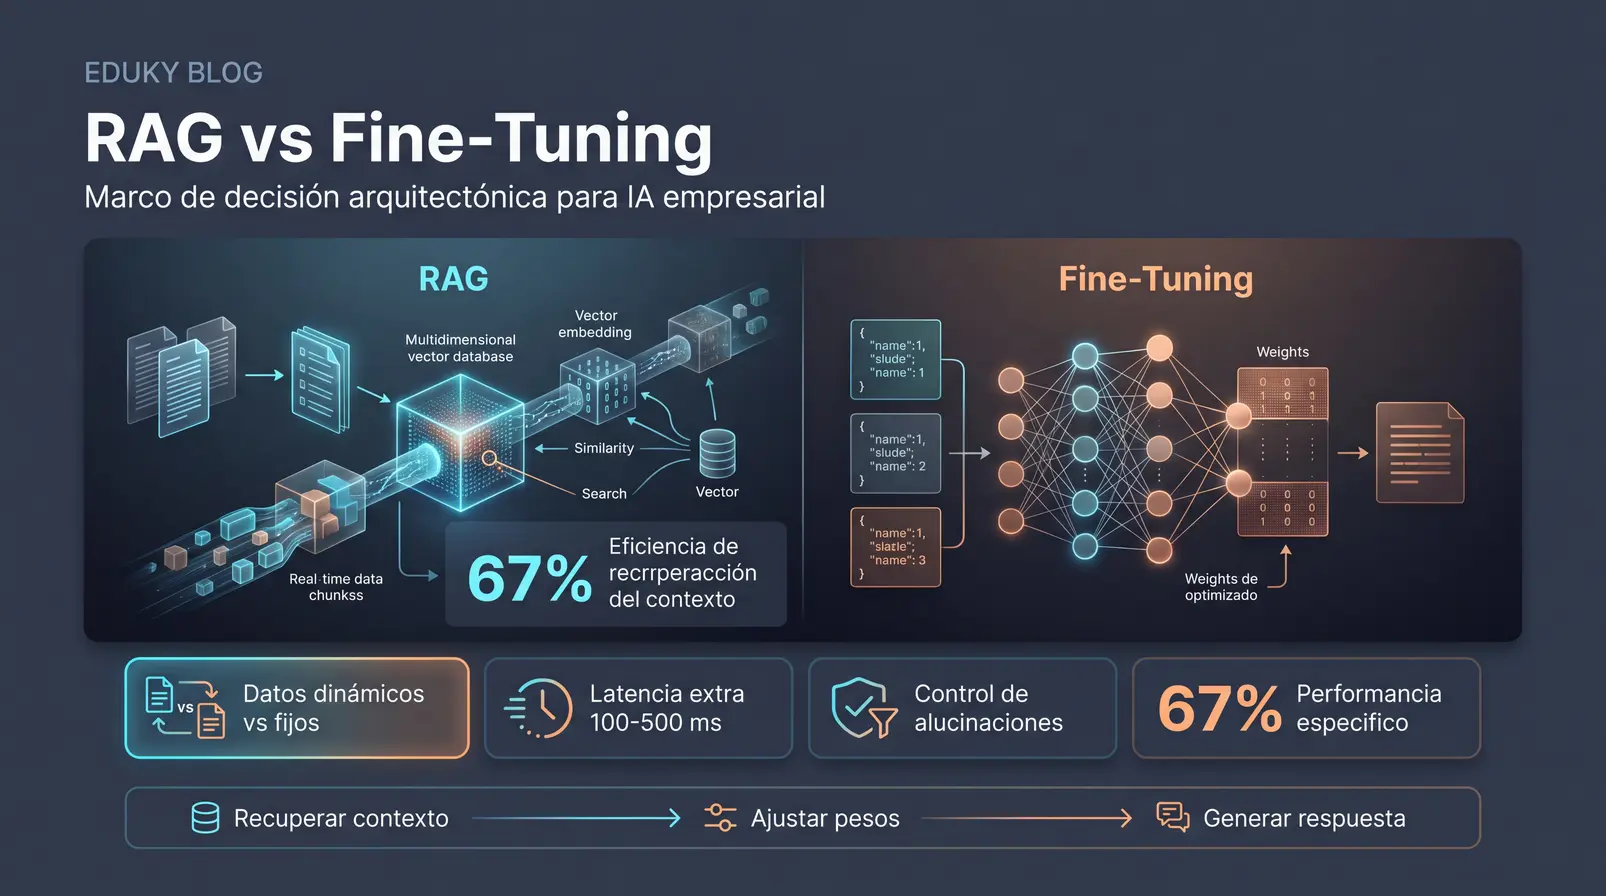
- RAG (Retrieval-Augmented Generation): Conecta dinámicamente el modelo con repositorios externos y bases de datos vectoriales sin modificar los pesos de la red neuronal.
- Fine-Tuning: Ajusta de forma permanente los parámetros del modelo mediante aprendizaje supervisado para fijar tono, formato estructurado o vocabulario especializado.
- Latencia operativa: Las canalizaciones RAG suelen añadir entre 100 y 500 ms por consulta debido al proceso de embedding, búsqueda y re-ranking.
- Actualización continua: RAG permite actualizar datos al instante mediante reindexación, mientras que el fine-tuning exige curar nuevos datasets y ejecutar ciclos de reentrenamiento GPU.
¿Qué es RAG y cómo funciona en tiempo de ejecución?
La Generación Aumentada por Recuperación (RAG) actúa como un sistema de consulta en tiempo real. En lugar de forzar al modelo a memorizar cada dato de tu organización, RAG busca los fragmentos documentales más pertinentes e inyecta esa información directamente en la ventana de contexto durante la inferencia.
Este proceso garantiza que el modelo trabaje con información fáctica reciente sin necesidad de alterar los parámetros internos de la red neuronal, habilitando la citación explícita de fuentes primarias y respetando los permisos de acceso documental.
El flujo operativo de una arquitectura RAG
Los documentos internos se dividen en fragmentos lógicos (chunks), se convierten en representaciones numéricas mediante un modelo de embeddings y se almacenan en una base vectorial.
La consulta del usuario se transforma en vector para identificar y recuperar los fragmentos documentales más semánticamente afines.
Los fragmentos seleccionados se reordenan según su relevancia y se concatenan en el prompt que recibe el modelo.
El LLM produce una respuesta estructurada basándose exclusivamente en los datos recuperados, permitiendo auditoría y citas precisas.
¿Qué es Fine-Tuning y cuándo aporta valor real?
El Fine-Tuning consiste en entrenar de forma supervisada una red neuronal preexistente con pares estructurados de entrada y salida. Este procedimiento modifica de manera permanente los pesos del modelo para enseñarle pautas de comportamiento, estilos narrativos específicos o sintaxis rígidas (como esquemas JSON rigurosos).
En modelos fundacionales modernos, iniciar un fine-tuning supervisado requiere desde tan solo 15 ejemplos estructurados hasta varios cientos según la complejidad del comportamiento deseado. Sin embargo, no debe utilizarse como una base de datos para almacenar hechos cambiantes.
RAG vs Fine-Tuning: Comparativa dimensional directa
Para determinar la viabilidad de cada tecnología en tus proyectos de software, conviene analizar sus repercusiones en términos de infraestructura, costes, gobernanza y tiempos de respuesta.
| Dimensión | RAG (Retrieval-Augmented Generation) | Fine-Tuning |
|---|---|---|
| Objetivo primario | Acceso a datos fácticos dinámicos y actualizables | Adaptación de tono, formato, sintaxis y estilo de respuesta |
| Pesos del modelo | Inalterados (modelo base intacto) | Modificados de forma permanente |
| Latencia por inferencia | Añade entre 100 y 500 ms por búsqueda vectorial y re-ranking | Latencia base de inferencia sin pasos intermedios de búsqueda |
| Actualización de datos | Instantánea mediante reindexación de vectores con bajo coste | Exige curar datasets y ejecutar ciclos de reentrenamiento GPU |
| Riesgo de alucinación | Bajo; permite citas directas y trazabilidad a la fuente | Riesgo latente de alucinación no rastreable ante datos nuevos |
| Optimización de tokens | Consume tokens adicionales por inyección de contexto documental | Reduce tokens de contexto al prescindir de extensas instrucciones |
Árbol de decisión estratégico paso a paso
Para definir tu arquitectura sin caer en fallos comunes de despliegue, evalúa tu caso de uso con las siguientes preguntas secuenciales:
- ¿Tus datos cambian diariamente o con frecuencia? Si la información es dinámica o regulada, opta prioritariamente por RAG para evitar continuos reentrenamientos.
- ¿Requieres auditoría estricta y citas comprobables? Elige RAG; el fine-tuning no previene por sí solo las alucinaciones cuando se le pregunta por hechos fuera de su distribución original.
- ¿Necesitas que el modelo responda con un formato JSON complejo o sintaxis interna muy especializada? Utiliza Fine-Tuning para internalizar la estructura sin agotar tokens de contexto en cada petición.
- ¿El volumen de peticiones es tan alto que el coste por token de contexto resulta prohibitivo? El Fine-Tuning puede amortizarse a gran escala al comprimir las directrices que de otro modo irían en el prompt.
Arquitecturas híbridas: Lo mejor de ambos mundos
En entornos empresariales y sectores regulados, la disyuntiva entre rag vs fine tuning suele resolverse mediante un enfoque híbrido. No son métodos excluyentes, sino componentes complementarios de una misma solución.
En un sistema híbrido, se realiza fine-tuning a un modelo para que adopte un vocabulario técnico especializado, responda con formatos estrictos o actúe como un clasificador preciso. En paralelo, este modelo fine-tuneado se conecta a un pipeline RAG que suministra los hechos verificados y las referencias documentales en tiempo de ejecución.
Asimismo, aplicar fine-tuning específico en los propios modelos de embeddings de dominio permite alcanzar entre un 10% y un 30% de mejora potencial en la precisión de recuperación vectorial, potenciando enormemente la calidad global de la canalización.
🚀 ¿Quieres estar siempre actualizado en IA?
Únete a nuestra comunidad donde compartimos noticias, herramientas, guías y oportunidades sobre inteligencia artificial.
Preguntas frecuentes
¿Puede el Fine-Tuning reemplazar una base de datos de conocimiento?
No. El fine-tuning modifica los pesos del modelo para internalizar patrones, tono y formatos, pero no fue diseñado para memorizar información fáctica dinámica y presenta riesgos de alucinación no rastreable ante consultas de datos específicos.
¿Cuánto tarda una consulta en un sistema RAG frente a un modelo fine-tuneado?
Las canalizaciones RAG agregan habitualmente una latencia de 100 a 500 ms atribuible al cálculo de embeddings, consulta a la base vectorial y reordenamiento de fragmentos, mientras que un modelo fine-tuneado responde con la latencia directa de inferencia.
¿Cuántos datos se necesitan para empezar a hacer fine-tuning?
En modelos fundacionales actuales, se puede comenzar un proceso de fine-tuning supervisado con un conjunto curado desde 15 ejemplos estructurados hasta varios cientos, dependiendo de la complejidad del formato o tarea requerida.
Fuentes consultadas
🔥 Sigue Eduky Blog para más contenido sobre IA
Noticias, herramientas, automatizaciones y guías prácticas para mantenerte siempre al día.

Publicar comentario