OpenAI o1 vs Claude 3.5 Sonnet: Comparativa de Rendimiento, SWE-bench y Costes de Inferencia
OpenAI o1 vs Claude 3.5 Sonnet: Comparativa de Rendimiento, SWE-bench y Costes de Inferencia
Comparativa técnica entre OpenAI o1 y Claude 3.5 Sonnet: SWE-bench Verified, razonamiento matemático AIME, precios de API y costes de reasoning tokens.
La confrontación técnica entre OpenAI o1 vs Claude 3.5 Sonnet marca un punto de inflexión en la selección de modelos de lenguaje para ingeniería de software. Mientras los equipos técnicos buscan automatizar tareas críticas de depuración, refactorización y lógica algorítmica, la industria se divide en dos paradigmas operacionales: la inferencia reflexiva con cadena de pensamiento interna frente a la ejecución contextual directa y ágil de alta velocidad.
Puntos clave de la comparativa
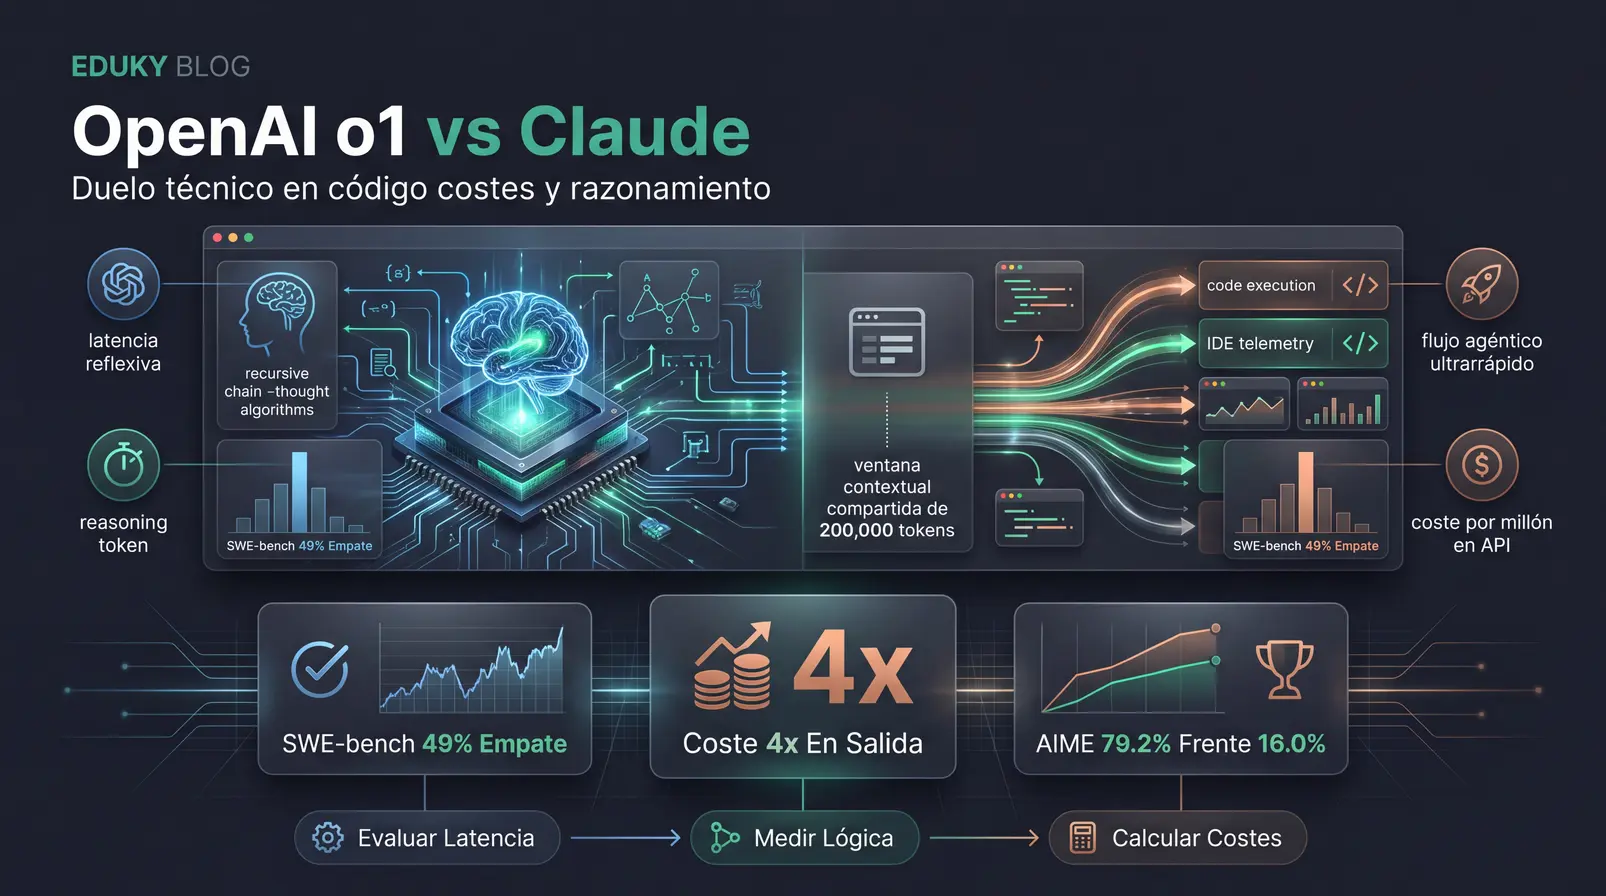
- Empate técnico en desarrollo real: Claude 3.5 Sonnet registra un 49.0% de resolución en SWE-bench Verified frente al 48.9% oficial de OpenAI o1.
- Disparidad en matemática formal: En la competición AIME 2024 (pass@1), OpenAI o1 alcanza un 79.2% frente al 16.0% de Claude 3.5 Sonnet sin razonamiento extendido.
- Diferencia económica drástica: La API de o1 cuesta $15.00/$60.00 por millón de tokens (input/output), frente a los $3.00/$15.00 por millón de tokens de Claude 3.5 Sonnet.
- Impacto de los reasoning tokens: Los tokens de pensamiento generados internamente por o1 son invisibles para el usuario pero se facturan íntegramente a tarifa de salida ($60/1M).
Resolución SWE-bench Verified (Claude vs o1)
Precisión AIME 2024 pass@1 (o1 vs Claude)
Multiplicador de coste en tokens de salida (o1 vs Sonnet)
Ventana contextual nativa en ambos modelos
Dos paradigmas de arquitectura: Inferencia reflexiva frente a ejecución ágil
La diferencia fundamental entre ambos sistemas radica en cómo procesan los problemas antes de devolver un solo carácter. Claude 3.5 Sonnet opera bajo el modelo tradicional de predicción token a token acelerada sobre una ventana de contexto de 200,000 tokens. Su fortaleza reside en la agilidad de respuesta, la comprensión de repositorios completos y la compatibilidad con interacciones agénticas mediante funciones como Computer Use.
En contraste, OpenAI o1 incorpora una inferencia reflexiva deliberada. Antes de emitir su respuesta al cliente, el modelo genera internamente una cadena de pensamiento oculta destinada a planificar, desglosar hipótesis y verificar sus propios pasos lógicos. Esto altera por completo los perfiles de latencia y facturación en flujos de producción.
Rendimiento en código: El test de SWE-bench Verified
Para medir el impacto práctico en proyectos de ingeniería de software, el estándar de referencia es SWE-bench Verified, una batería de pruebas que enfrenta a los modelos con incidencias reales y pull requests de repositorios abiertos complejos.
Los datos demuestran un rendimiento prácticamente idéntico en resolución base de incidencias:
- Claude 3.5 Sonnet: 49.0% de problemas resueltos con éxito.
- OpenAI o1: 48.9% de problemas resueltos en su configuración base de evaluación de la API.
No obstante, la investigación técnica subraya que estos resultados varían según el entorno de ejecución (agent scaffolding). En frameworks especializados que habilitan comandos bash, inspección iterativa y ejecución paralela, agentes potenciados con o1 han reportado hasta un 64.6% de éxito. Por su parte, Sonnet ofrece una integración fluida e instantánea dentro de editores de código interactivos, manteniendo la consistencia sin pausas prolongadas de cómputo.
La economía de la inferencia: Precios de API y reasoning tokens
El aspecto financiero representa la mayor divergencia en la comparativa entre OpenAI o1 vs Claude 3.5 Sonnet. Los equipos de infraestructura deben evaluar detenidamente el coste por petición cuando diseñan arquitecturas a escala.
| Criterio Técnico | OpenAI o1 | Claude 3.5 Sonnet |
|---|---|---|
| Coste Input (1M tokens) | $15.00 | $3.00 |
| Coste Output (1M tokens) | $60.00 | $15.00 |
| Tratamiento de Reasoning Tokens | Facturados íntegramente como output ($60/1M) | No aplica (sin computación reflexiva oculta) |
| Ventana de Contexto | 200,000 tokens | 200,000 tokens |
| SWE-bench Verified | 48.9% | 49.0% |
| AIME 2024 (pass@1) | 79.2% | 16.0% |
Matemáticas avanzadas y formulación de algoritmos
Donde la computación en tiempo de inferencia de OpenAI o1 exhibe una ventaja contundente es en tareas de razonamiento formal y diseño matemático puro. En la prueba AIME 2024 (American Invitational Mathematics Examination), o1 alcanza un 79.2% de precisión en pass@1, mientras que Claude 3.5 Sonnet se sitúa en un 16.0% al carecer de este mecanismo reflexivo nativo.
Esta disparidad evidencia que para optimización combinatoria, criptografía, formulación de modelos estadísticos y validación estricta de teoremas lógicos, o1 compensa su elevado coste de procesamiento reduciendo alucinaciones estructurales.
Flujo de decisión técnica: Cuándo usar cada modelo
Si la tarea forma parte de un entorno interactivo en IDEs, generación frontend o refactorización continua donde la respuesta debe ser inmediata, Claude 3.5 Sonnet es la opción óptima por su velocidad y bajo coste.
Si la solicitud involucra algoritmos complejos de grafos, deducción deductiva sin errores o problemas de optimización crítica, la cadena de pensamiento de OpenAI o1 reduce drásticamente el error conceptual.
Para pipelines por lotes con millones de tokens de salida diarios, Claude 3.5 Sonnet mantiene los costes de inferencia cuatro veces más bajos en tarifa base, evitando sobrecostes por tokens invisibles.
🚀 ¿Quieres estar siempre actualizado en IA?
Únete a nuestra comunidad donde compartimos noticias, herramientas, guías y oportunidades sobre inteligencia artificial.
Preguntas frecuentes
¿Puedo inspeccionar la cadena de pensamiento completa en OpenAI o1?
No. Por motivos de propiedad intelectual y alineación de seguridad, OpenAI no entrega los tokens de razonamiento originales sin editar a través de la API; el desarrollador solo recibe resúmenes o el recuento total de tokens consumidos.
¿Por qué empatan en SWE-bench si o1 es superior en razonamiento matemático?
SWE-bench evalúa resolución práctica de incidencias en código existente (búsqueda de archivos, lectura de sintaxis, parches en librerías), áreas donde la velocidad y comprensión contextual directa de Claude 3.5 Sonnet compiten a la par de la deliberación algorítmica de o1.
¿Ambos modelos soportan la misma cantidad de contexto?
Sí, tanto OpenAI o1 como Claude 3.5 Sonnet admiten ventanas de contexto máximas de hasta 200,000 tokens, aunque la latencia para procesar y responder varía significativamente en o1 debido al tiempo de inferencia reflexiva.
Fuentes consultadas
🔥 Sigue Eduky Blog para más contenido sobre IA
Noticias, herramientas, automatizaciones y guías prácticas para mantenerte siempre al día.

Publicar comentario