Evaluación de agentes de IA: Guía práctica para medir precisión y fiabilidad en producción
Evaluación de agentes de IA: Guía práctica para medir precisión y fiabilidad en producción
Aprende a medir la fiabilidad de agentes autónomos con el marco de Anthropic: métricas pass@k, validación por código, LLM-as-a-judge y control de regresión.
Puntos clave del marco de evaluación
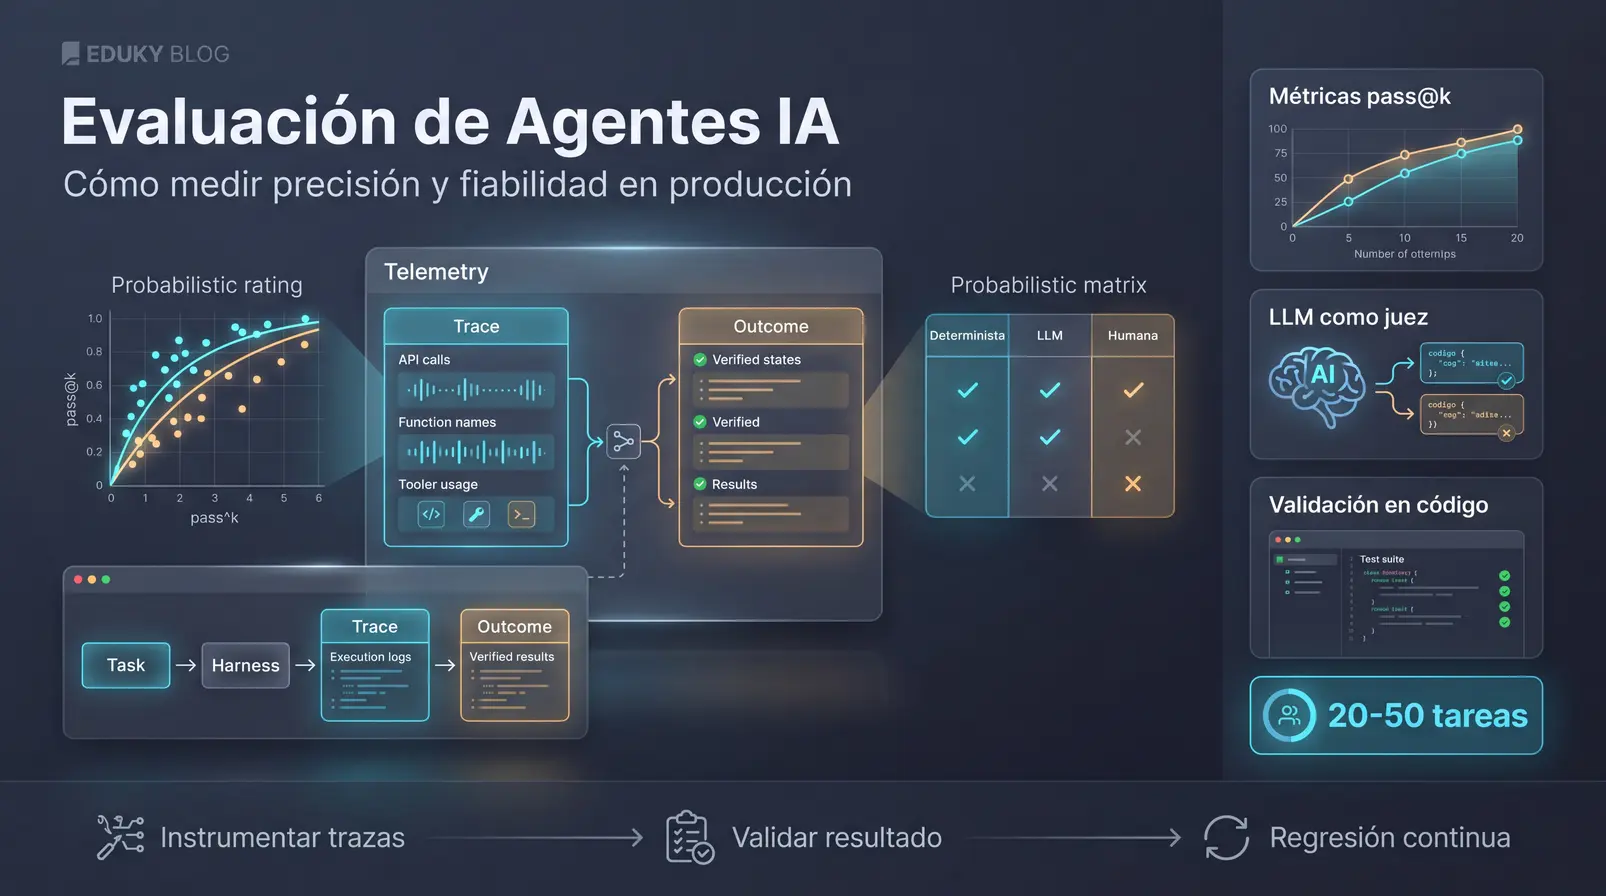
- El sistema completo a examen: Evaluar un agente no implica probar el modelo aislado, sino todo su arnés (prompts, herramientas y orquestación).
- Diferencia entre traza y resultado: Un agente puede afirmar que resolvió un problema mientras el entorno real sigue sin cambios.
- Caja de herramientas triple: Integración de validadores en código determinista, jueces LLM y revisión humana de referencia.
- Fiabilidad probabilística: Uso de métricas complementarias (pass@k y pass^k) para medir capacidad y consistencia en múltiples intentos.
La evaluación de agentes de IA se ha convertido en el desafío técnico más relevante al llevar flujos de trabajo autónomos a producción. Cuando un modelo de lenguaje deja de ser una simple interfaz de preguntas y respuestas para interactuar con bases de datos, APIs o navegadores web, las técnicas tradicionales de prueba quedan obsoletas.
Para establecer un estándar cuantitativo y reproducible, Anthropic presentó en enero de 2026 una guía metodológica detallada para desmitificar las evaluaciones en agentes de IA. Si estás diseñando o implementando asistentes que ejecutan acciones en múltiples turnos, necesitas comprender cómo medir su precisión, aislar fallos en cascada y asegurar que su comportamiento se mantenga estable con cada cambio de prompt o código.
Por qué evaluar agentes de IA no es lo mismo que evaluar modelos de chat
En un sistema de conversación de un único turno (single-turn), la evaluación consiste principalmente en contrastar el texto generado contra una respuesta esperada. En cambio, los agentes operan en bucles continuos: reciben una meta, formulan un plan, invocan herramientas externas, observan el resultado de esa invocación y ajustan su estrategia en consecuencia.
Este ciclo introduce dos retos esenciales: el no determinismo estocástico y la posibilidad de fallos en cascada. Un error menor al interpretar el esquema de una API en el paso 1 puede desviar por completo los pasos subsiguientes, culminando en un desenlace fallido a pesar de que el razonamiento textual aparente ser coherente.
La anatomía de una evaluación agéntica
El marco de Anthropic desglosa la infraestructura de pruebas en seis componentes formales interconectados:
La consigna, el objetivo o el problema inicial que se le presenta al agente junto con las condiciones de partida.
El entorno de ejecución, herramientas disponibles, prompts del sistema y controles de orquestación que rodean al modelo.
El registro secuencial de todos los pasos intermedios: llamadas a herramientas, argumentos, salidas y reflexiones internas.
El estado final real en el que queda el entorno externo tras la conclusión de la tarea.
El mecanismo encargado de emitir una puntuación o veredicto sobre la traza, el resultado o ambos.
Una ejecución única e independiente de una tarea concreta a través de todo el flujo evaluador.
La caja de herramientas de validación: tres tipos de calificadores
Ningún método de validación individual es suficiente para cubrir la complejidad de un agente. El marco formaliza una matriz híbrida compuesta por tres tipos de calificadores con roles definidos:
| Tipo de calificador | Mecanismo principal | Fortalezas | Limitaciones identificadas |
|---|---|---|---|
| Código determinista | Pruebas unitarias, expresiones regulares, validación de estado final en base de datos. | Rápido, económico, 100% reproducible y objetivo. | Rígido; no evalúa matices conversacionales ni explicaciones abiertas. |
| Modelo (LLM-as-a-judge) | Un LLM evaluador guiado por una rúbrica formal detallada. | Escalable; juzga razonamiento intermedio, tono y cumplimiento de criterios complejos. | Sujeto a sesgos de longitud, de posición y favoritismo hacia su propia familia de modelos. |
| Revisión humana | Expertos de dominio que auditan manualmente trazas y resultados. | El estándar de referencia (ground truth) para calibrar evaluadores automáticos. | Costoso, lento e inviable para compuertas de despliegue continuo (CI/CD). |
Buenas prácticas de calibración: Para evitar sesgos al emplear modelos como jueces, se requiere una calibración periódica contrastando sus veredictos frente a conjuntos de datos calificados por humanos.
Manejo del no determinismo: métricas pass@k y pass^k
Dado que las respuestas de los modelos son probabilísticas, ejecutar una prueba agéntica una sola vez ofrece una falsa sensación de seguridad. El marco propone ejecutar múltiples ensayos (trials) por tarea y calcular dos métricas complementarias:
Si un agente obtiene un pass@5 alto pero su pass^5 es cercano a cero, significa que el sistema posee la habilidad para resolver la tarea, pero carece de la consistencia necesaria para operar de forma autónoma sin supervisión humana constante.
Suites de capacidad frente a suites de regresión
La evaluación continua exige estructurar las baterías de prueba según su objetivo operativo:
- Suites de capacidad (Capability evals): Diseñadas deliberadamente con tareas de alta dificultad donde la tasa de éxito inicial es baja. Su propósito es explorar la frontera de habilidades del agente e identificar qué tipos de problemas aún no puede solucionar.
- Suites de regresión (Regression evals): Diseñadas con tareas estándar donde el agente ya tiene un rendimiento comprobado cercano al 100%. Se ejecutan de manera automatizada en pipelines de integración continua (CI/CD) para garantizar que una modificación en un prompt o herramienta no degrade capacidades previas.
Hoja de ruta: cómo implementar el marco desde cero
La implementación de un sistema de evaluación no requiere suites masivas desde el primer día. La metodología documenta una ruta de madurez dividida en 8 pasos estructurados:
- Paso 1: Muestra inicial acotada. Comenzar con un conjunto representativo de 20 a 50 tareas reales extraídas del dominio operativo en lugar de esperar bancos de pruebas gigantescos.
- Paso 2: Instrumentación de trazas. Configurar el arnés para registrar cada llamada a herramientas, argumento, latencia y respuesta.
- Paso 3: Validadores en código. Implementar comprobaciones deterministas del estado final del entorno (outcome).
- Paso 4: Rúbricas para LLM-as-a-judge. Definir criterios claros para calificar razonamientos intermedios complejos.
- Paso 5: Calibración humana. Validar que las calificaciones del modelo coincidan con el criterio de revisores humanos en casos borde.
- Paso 6: Medición multi-ensayo. Calcular métricas pass@k y pass^k para diagnosticar la variabilidad estocástica.
- Paso 7: Suite de regresión en CI/CD. Congelar las tareas resueltas como compuertas automáticas para autorizar despliegues.
- Paso 8: Estandarización de infraestructura. Aislar entornos (sandboxes) y homogeneizar cuotas de API, memoria RAM y límites de tiempo para evitar ruido en los benchmarks.
🚀 ¿Quieres estar siempre actualizado en IA?
Únete a nuestra comunidad donde compartimos noticias, herramientas, guías y oportunidades sobre inteligencia artificial.
Preguntas frecuentes
¿Por qué empezar con solo 20 a 50 tareas?
Anthropic recomienda iniciar con este rango porque permite iterar rápidamente y entender los patrones de fallo reales del agente sin la sobrecarga operativa de gestionar bancos de pruebas masivos desde el inicio.
¿Qué diferencia a pass@k de pass^k?
pass@k calcula la probabilidad de lograr el éxito en al menos uno de k intentos, sirviendo para medir si el agente tiene la capacidad técnica. pass^k evalúa si el agente supera la tarea en todos los k intentos de forma consecutiva, midiendo su consistencia sin errores.
¿Cuáles son los principales sesgos del LLM-as-a-judge?
Los evaluadores basados en modelos tienden a presentar sesgo de posición (preferir la primera opción evaluada), sesgo de longitud (calificar mejor respuestas más extensas) y sesgo de benevolencia hacia respuestas generadas por modelos de su misma familia.
Fuentes consultadas
🔥 Sigue Eduky Blog para más contenido sobre IA
Noticias, herramientas, automatizaciones y guías prácticas para mantenerte siempre al día.

Publicar comentario