Prompt Caching en Claude: Cómo reducir hasta un 90% en costes y 85% en latencia
Prompt Caching en Claude: Cómo reducir hasta un 90% en costes y 85% en latencia
Aprende a estructurar tus prompts para activar Prompt Caching en Claude: ahorra hasta 90% en tokens de entrada y reduce la latencia de respuesta en un 85%.
El uso intensivo de modelos de lenguaje en flujos de trabajo profesionales suele chocar con dos barreras inevitables: facturas elevadas por el reprocesamiento continuo de contexto y tiempos de espera molestos. Dominar la técnica de Prompt Caching permite transformar la arquitectura de tus peticiones para que la API reutilice cómputo previo en lugar de recalcular cada token desde cero.
Claves del Prompt Caching
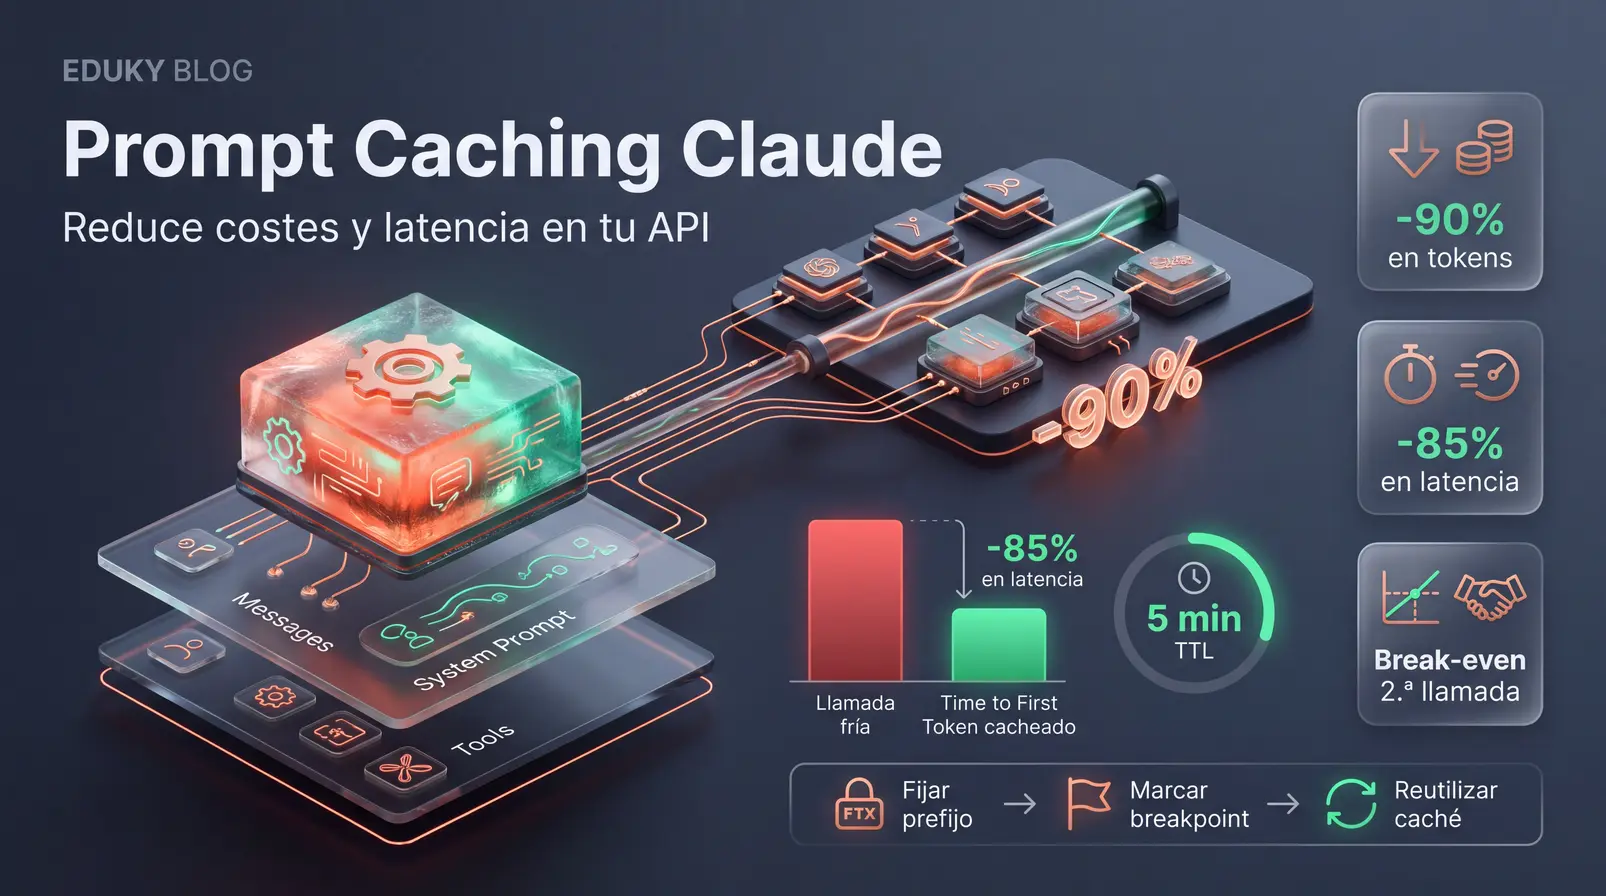
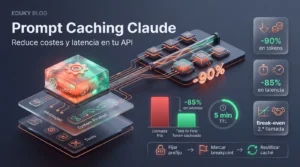
- Ahorro sustancial: Hasta un 90% de descuento en tokens de entrada reciclados (e incluso 95% a 97.5% en modelos recientes como Sonnet/Opus 5.5 y Fable/Mythos 5.1).
- Velocidad de respuesta: Disminución de hasta un 85% en el Time to First Token (TTFT) al evitar recalcular matrices de atención.
- Jerarquía rígida: La caché procesa en orden estricto: herramientas (tools), instrucciones de sistema (system) y mensajes (messages).
- Rentabilidad inmediata: Aunque escribir en caché tiene un sobrecoste del 25% (1.25x), el punto de equilibrio económico se alcanza a partir de la segunda consulta recurrente.
¿Qué es Prompt Caching y cómo transforma la economía de los LLMs?
Cada vez que envías un documento largo, una especificación de código o un manual corporativo a un LLM convencional, el sistema debe computar y procesar todos esos tokens repetidamente en cada turno de conversación. El Prompt Caching es una funcionalidad a nivel de API diseñada para memorizar y reutilizar los prefijos estáticos de tokens entre múltiples llamadas consecutivas.
En lugar de reconstruir las matrices de atención (KV cache) desde la nada, el proveedor lee directamente del estado en memoria los datos previamente procesados. Esta mecánica no solo desploma la latencia inicial de respuesta hasta en un 85%, sino que disminuye drásticamente el coste por token de entrada recurrente.
La anatomía del prompt perfecto para aprovechar la caché
Para que el motor de Anthropic reutilice la memoria efímera, existe una regla estricta: la correspondencia del prefijo debe ser exacta carácter a carácter. El procesamiento sigue un flujo acumulativo inalterable. Si cambias un solo espacio en una etapa temprana, todo el contenido posterior queda invalidado.
Define aquí los esquemas estáticos de tus herramientas o APIs externas. Al colocarlas en la cima, permanecen cacheadas independientemente del usuario.
Ubica las directrices de rol, manuales operativos, ejemplos de pocas muestras (few-shot examples) y bases documentales de referencia fijas.
Coloca la consulta puntual del usuario, marcas de tiempo e identificadores de sesión al final. Todo lo dinámico debe residir después del último breakpoint de caché.
Cálculo financiero y retorno de inversión: ¿Cuándo conviene cachear?
La implementación de Prompt Caching introduce una tarifa diferenciada para la escritura inicial frente a las lecturas posteriores. Escribir un bloque estático en caché con un tiempo de vida (TTL) estándar de 5 minutos tiene un recargo del 25% (tarifa de 1.25x respecto al precio base de entrada). Por su parte, la escritura con TTL extendido de 1 hora tiene una tarifa de 2.0x (100% extra).
A cambio, cada lectura confirmada (cache hit) cuesta tan solo 0.1x (un 90% de descuento) en la mayoría de modelos Claude, reduciéndose a 0.05x (95% de descuento) en Opus 5.5 y Sonnet 5.5, e incluso 0.025x en modelos como Fable 5.1 y Mythos 5.1.
| Acción / Parámetro | Tarifa relativa | Efecto financiero |
|---|---|---|
| Token de entrada regular (sin caché) | 1.0x | Coste base estándar en cada llamada |
| Escritura en caché (TTL 5 min) | 1.25x | Sobrecoste de 25% solo en la 1.ª petición |
| Escritura en caché (TTL 1 hora) | 2.0x | Sobrecoste de 100% para sesiones extensas |
| Lectura de caché (Cache Hit estándar) | 0.1x | 90% de ahorro directo en entradas recicladas |
| Lectura en Sonnet 5.5 y Opus 5.5 | 0.05x | 95% de ahorro en tokens de entrada reutilizados |
El punto de equilibrio se logra rápidamente: dos consultas consecutivas sin caché suman un coste relativo de 2.0x. Con caché efímera de 5 minutos, la primera llamada cuesta 1.25x y la segunda apenas 0.1x, logrando un coste combinado de 1.35x. A partir del segundo uso dentro del TTL, el sistema genera un retorno neto.
Implementación práctica: Caching Automático vs. Breakpoints Explícitos
Existen dos formas técnicas de indicarle al modelo qué fragmentos deben conservarse en memoria:
1. Caching Automático
Se configura incluyendo un único bloque cache_control en el nivel superior de la solicitud API. El sistema desplaza de manera dinámica el punto de control hacia el último bloque válido antes del contenido variable del usuario.
2. Breakpoints Explícitos
Permite colocar marcas manuales mediante el parámetro "cache_control": {"type": "ephemeral"} en secciones específicas. La plataforma admite hasta 4 breakpoints explícitos por solicitud, ideales para separar la documentación fija del historial conversacional reciente.
Ejemplo de estructura de prompt optimizada para API
{
  "model": "claude-3-7-sonnet",
  "system": [
    {
      "type": "text",
      "text": "Eres un asistente legal corporativo. Analiza las dudas basándote exclusivamente en este manual normativo de 15,000 tokens: [INSERTE TEXTO EXTENSO DE NORMATIVAS]...",
      "cache_control": { "type": "ephemeral" }
    }
  ],
  "messages": [
    {
      "role": "user",
      "content": "¿Cuál es el procedimiento de rescisión establecido en la cláusula 4?"
    }
  ]
}Los 4 errores críticos que invalidan tu caché
Cometer descuidos menores de formateo puede provocar que pagues repetidamente el recargo de escritura de 1.25x sin obtener los descuentos de lectura de 0.1x. Presta atención a estos escenarios habituales:
- Inyección de marcas temporales: Colocar
Timestamp actual: [HH:MM:SS]dentro de las instrucciones del sistema invalida la correspondencia carácter a carácter en cada llamada. - IDs de sesión dentro del prefijo estático: Incluir variables que cambian por usuario dentro del bloque cacheado destruye la reutilización para consultas posteriores.
- Límite de la ventana de retroceso (Lookback Window): La reconciliación de caché busca como máximo en 20 bloques contiguos. Si una conversación avanza 20 turnos sin un nuevo breakpoint, el sistema dejará de detectar la caché original.
- Llamadas paralelas simultáneas al inicio: En ejecuciones concurrentes, la caché solo se consolida al comenzar la respuesta de la primera consulta. Disparar diez peticiones idénticas en el milisegundo cero provocará diez escrituras a coste completo.
🚀 ¿Quieres estar siempre actualizado en IA?
Únete a nuestra comunidad donde compartimos noticias, herramientas, guías y oportunidades sobre inteligencia artificial.
Preguntas frecuentes
¿Qué sucede si mi prompt no alcanza el mínimo de 512 tokens?
La solicitud se ejecuta de forma habitual con las tarifas estándar de entrada. No se almacena nada en la caché efímera, pero tampoco se genera ningún error en la llamada API.
¿Cuánto tiempo dura la caché si sigo haciendo consultas?
El TTL estándar es de 5 minutos, pero cada vez que se produce una lectura exitosa (cache hit), el contador de 5 minutos se renueva automáticamente sin coste extra de escritura.
¿Se pueden cachear bloques de razonamiento (thinking)?
Los bloques de razonamiento interno no se pueden marcar directamente con cache_control, aunque pueden reutilizarse de forma natural una vez que ya quedan incorporados en el historial de mensajes de turnos previos del asistente.
Fuentes consultadas
🔥 Sigue Eduky Blog para más contenido sobre IA
Noticias, herramientas, automatizaciones y guías prácticas para mantenerte siempre al día.

Publicar comentario