Prompting multimodal en Gemini: cómo dominar video, audio y marcas de tiempo
Prompting multimodal en Gemini: cómo dominar video, audio y marcas de tiempo
Aprende las reglas técnicas y sintaxis de prompting multimodal en Gemini para analizar video y audio con marcas de tiempo precisas y sin alucinaciones.
El análisis de contenido audiovisual mediante inteligencia artificial ha dado un salto cualitativo significativo, pero aprovecharlo al máximo exige dominar las reglas del prompting multimodal gemini. Muchos usuarios cometen el error de tratar los archivos de video y audio como simples bloques de texto, sufriendo respuestas truncadas o inexactitudes temporales. Dominar la sintaxis de marcas de tiempo y comprender cómo el modelo procesa cada fotograma transforma por completo la calidad de los resultados.
Puntos clave del prompting audiovisual en Gemini
- Sintaxis MM:SS: Formato estándar obligatorio para solicitar o referenciar momentos temporales precisos sin inducir alucinaciones.
- Posición del prompt: La instrucción debe colocarse después del archivo multimedia dentro del arreglo de entrada para optimizar la atención del modelo.
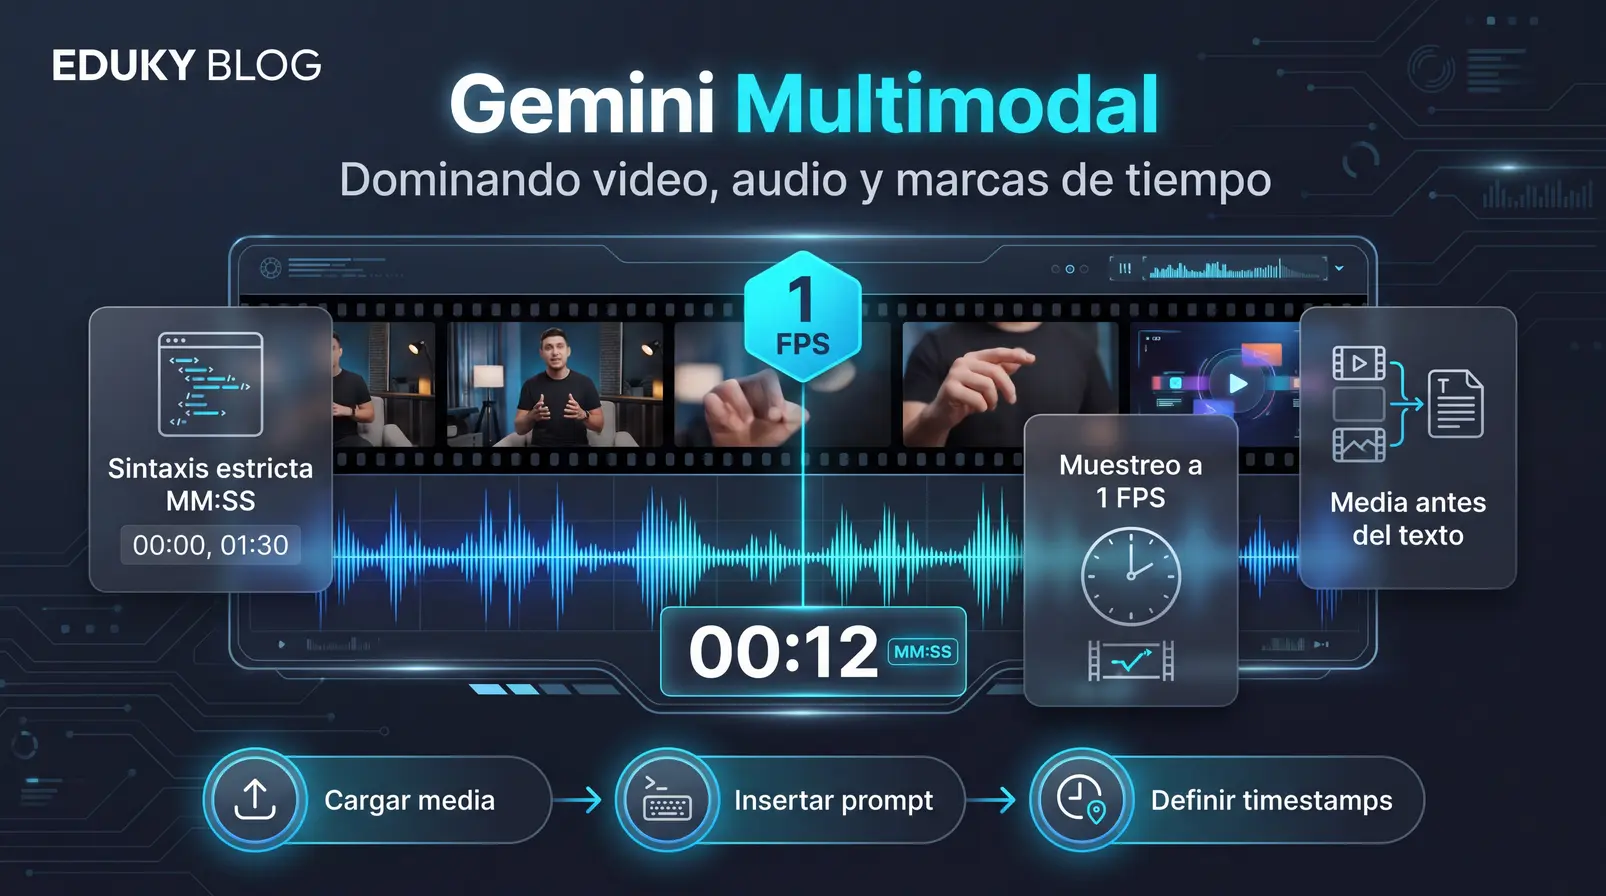
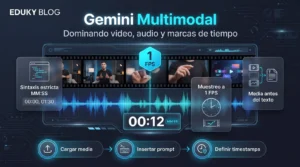
- Tasa de muestreo de 1 FPS: Gemini procesa video muestreando 1 fotograma por segundo junto con la pista de audio a 1 Kbps.
- Consumo de tokens: Cada segundo de video insume unos 300 tokens en resolución predeterminada y alrededor de 100 tokens en baja resolución.
- Files API: Esencial para archivos mayores a 20 MB o videos de más de 1 minuto, admitiendo hasta 20 GB en planes de pago.
Fundamentos técnicos: cómo procesa Gemini el video y el audio
Para construir instrucciones efectivas, es indispensable comprender la ingeniería interna del modelo. En las tareas de video understanding gemini api, el sistema no mira el video en tiempo real de forma continua, sino que muestrea sistemáticamente a razón de 1 fotograma por segundo (1 FPS). De forma paralela, el audio se procesa en canal único a 1 Kbps, sincronizando marcas de tiempo internas en cada segundo de reproducción.
Muestreo visual predeterminado del video
Costo de contexto por fotograma estándar
Consumo de contexto de la pista de audio
Gasto total por segundo de video estándar
Este desglose explica por qué un video extenso puede saturar rápidamente una ventana de contexto. Cuando se utiliza la configuración estándar, un minuto de video consume aproximadamente 18.000 tokens (alrededor de 300 tokens por segundo, que suman 258 del fotograma visual, 32 del canal de audio y los metadatos correspondientes). En modo de baja resolución (media_resolution='low'), el fotograma se reduce a 66 tokens, recortando el costo total a unos 100 tokens por segundo.
La regla de oro: sintaxis de timestamps y estructura del prompt
Uno de los descubrimientos documentados por Google AI for Developers es que el orden de los elementos en la solicitud altera de forma sustancial la precisión del análisis. La directriz oficial establece dos normas básicas:
El archivo de video o audio debe figurar en la primera posición del array de entrada (contents), ya sea mediante base64 para clips diminutos o vía Files API.
Colocar la instrucción escrita inmediatamente DESPUÉS del medio audiovisual maximiza la atención del modelo y la coherencia en la extracción de respuestas.
Especificar minutos y segundos como MM:SS (o HH:MM:SS si el material supera la hora) ancla al modelo a los marcadores internos sincronizados.
Plantillas prácticas de prompting multimodal en Gemini
Al analizar video con gemini, formular preguntas abiertas como «resume este video» genera respuestas superficiales y propensas a omitir detalles críticos. En su lugar, es recomendable utilizar directivas estructuradas que aprovechen la sincronización visual y sonora.
Plantilla 1: Minutas ejecutivas y diarización con marcas de tiempo
Esta estructura resulta óptima para grabaciones de reuniones, entrevistas o llamadas grupales donde se requiere identificar a los interlocutores y sus conclusiones.
Estructura del prompt:
[Archivo de video/audio adjunto]
Actúa como un asistente ejecutivo. Analiza el audio y la imagen del video proporcionado y genera una minuta con las siguientes instrucciones:
1. Identifica a cada participante usando las pistas visuales y de audio (diarización).
2. Para cada tema tratado, indica la marca de tiempo de inicio y fin en formato MM:SS.
3. Extrae en una lista con viñetas los acuerdos específicos adoptados y quién asumió la responsabilidad de cada uno.
4. No asumas acuerdos que no hayan sido mencionados verbalmente o mostrados en diapositivas. Salida exclusivamente en texto claro y profesional.
Plantilla 2: Extracción tabular comparativa de escenas y audio
Cuando se requiere auditar contenido publicitario, tutoriales o revisiones técnicas, organizar el resultado en tablas Markdown evita la dispersión y ahorra tokens de salida.
Estructura del prompt:
[Archivo de video adjunto]
Examina detalladamente el video y genera una tabla Markdown con el siguiente esquema de columnas:
– | Marca de tiempo (MM:SS) | Elementos visuales en pantalla | Diálogo / Audio clave | Tono o emoción detectada |
Agrupa los eventos cronológicamente según los cambios de escena o transiciones temáticas principales. Mantén las descripciones visuales concisas y objetivas.
Gemini cuenta con la capacidad verificada de sincronizar la pista de audio y la visual para identificar el tono emocional del orador junto con los gestos o diapositivas exhibidas en ese mismo segundo exacto.
| Parámetro | Resolución Predeterminada | Modo Baja Resolución (media_resolution=’low’) |
|---|---|---|
| Tokens por fotograma visual | 258 tokens | 66 tokens |
| Tokens de audio | 32 tokens/segundo | 32 tokens/segundo |
| Consumo total por segundo | ~300 tokens/s | ~100 tokens/s |
| Uso recomendado | Inspección de texto pequeño o detalles visuales finos | Videos extensos, conferencias, podcasts y minutas generales |
Gestión de archivos extensos y límites de la API
El método de carga condiciona la estabilidad de la inferencia. De acuerdo con la documentación de Google, los clips pequeños pueden pasarse como datos en línea (inline base64), pero existen restricciones técnicas determinantes:
- Umbral de 20 MB o 1 minuto: Cualquier archivo que supere estas cifras debe procesarse obligatoriamente a través de la Files API en vez de inline data.
- Capacidades de almacenamiento: La Files API admite hasta 2 GB por archivo en el tier gratuito y escala hasta 20 GB para proyectos en tiers de pago.
- Estado ACTIVE: Los videos pesados requieren procesamiento asíncrono previo. Es necesario sondear el estado del archivo hasta que marque
ACTIVEantes de lanzar la inferencia. - Foco por consulta: Se desaconseja enviar múltiples videos largos simultáneamente en un único prompt para eludir confusiones multimodales en el modelo.
MM:SS y recurre a media_resolution='low' cuando proceses contenido prolongado para economizar tokens sin sacrificar la comprensión semántica.
🚀 ¿Quieres estar siempre actualizado en IA?
Únete a nuestra comunidad donde compartimos noticias, herramientas, guías y oportunidades sobre inteligencia artificial.
Preguntas frecuentes
¿Por qué Gemini a veces no detecta un texto que apareció en pantalla?
Debido a que el modelo muestrea el video a razón de 1 fotograma por segundo (1 FPS), cualquier texto o elemento visual fugaz que permanezca en pantalla durante menos de un segundo podría no ser capturado en el fotograma procesado.
¿Cuál es la diferencia de sintaxis para videos de más de una hora?
Para duraciones inferiores a una hora se recomienda el formato estándar MM:SS (por ejemplo, 14:20). Para grabaciones que exceden los 60 minutos, la sintaxis correcta pasa a ser HH:MM:SS (por ejemplo, 01:15:30).
¿Cuándo conviene utilizar media_resolution=’low’?
Se recomienda al analizar videos largos, podcasts o conferencias donde el valor principal radica en el discurso y la estructura general, ya que reduce el consumo de 300 a solo 100 tokens por segundo.
Fuentes consultadas
🔥 Sigue Eduky Blog para más contenido sobre IA
Noticias, herramientas, automatizaciones y guías prácticas para mantenerte siempre al día.

Publicar comentario