Cómo construir un agente de IA autónomo conectado a tus documentos usando n8n (Guía RAG)
Cómo construir un agente de IA autónomo conectado a tus documentos usando n8n (Guía RAG)
Aprende a crear un agente de IA autónomo conectado a tus documentos con n8n usando RAG. Guía paso a paso sobre indexación, bases vectoriales y automatización.
Crear un agente de IA con documentos propios permite transformar manuales técnicos, reportes y bases de conocimiento internas en un asistente interactivo y preciso. Gracias a las capacidades de IA avanzada (Advanced AI) de n8n, es posible diseñar sistemas de Generación Aumentada por Recuperación (RAG) sin escribir código desde cero y conectarlos con los canales que tu equipo ya utiliza a diario.
Puntos clave del tutorial
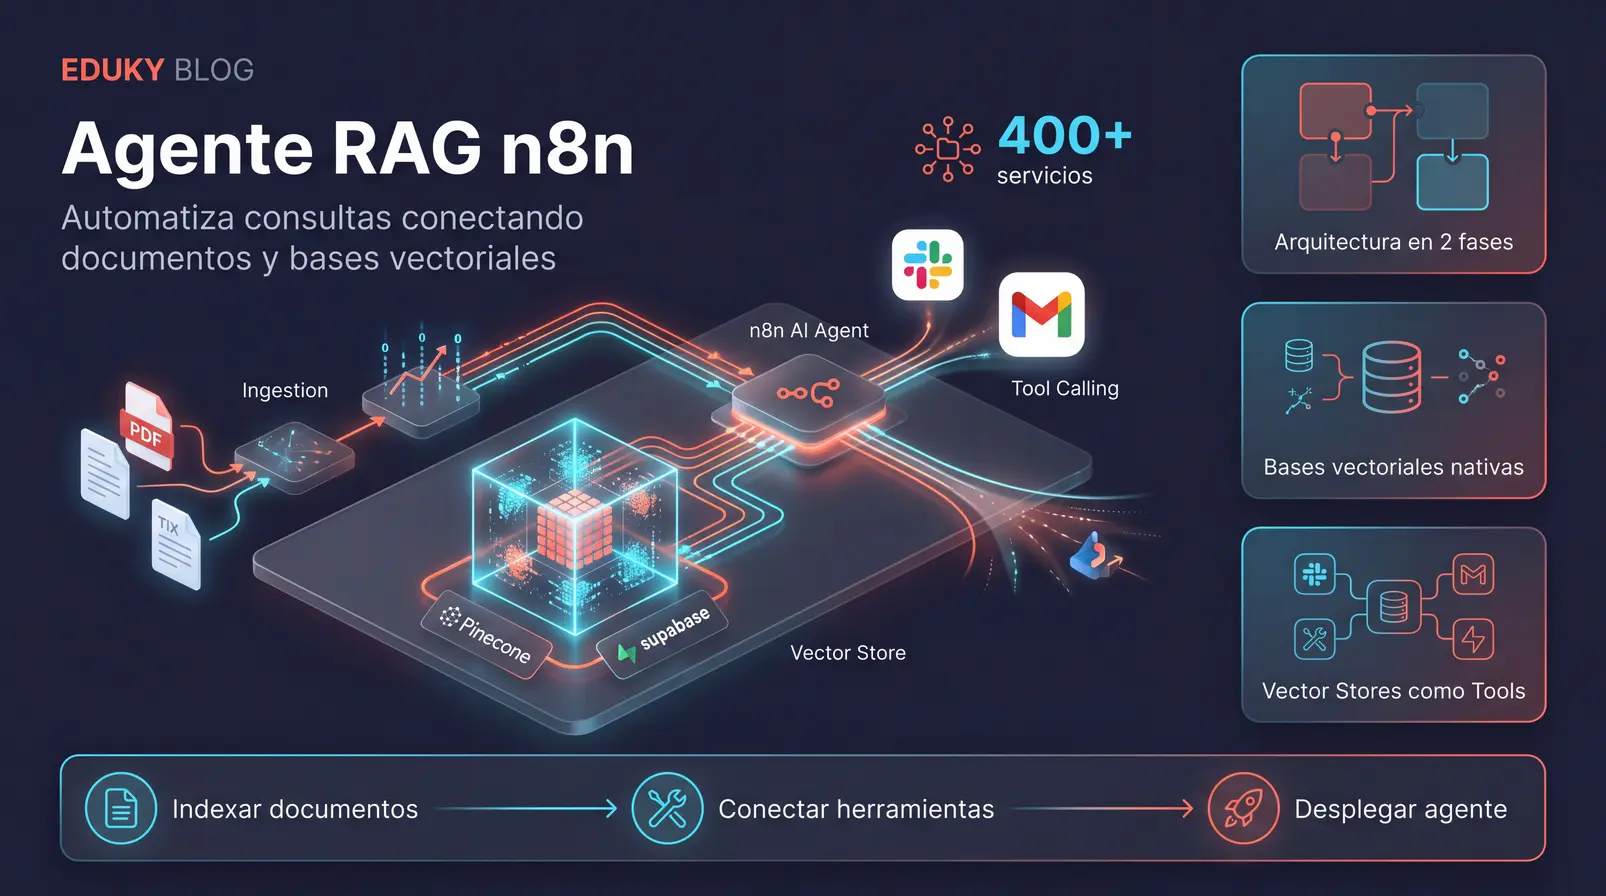
- Arquitectura en dos fases: Separar el flujo de indexación periódica del flujo de consulta en tiempo real evita sobrecostos y demoras.
- Bases vectoriales nativas: Soporte para motores escalables como Pinecone, Supabase (pgvector) y Qdrant, además de opciones locales de prueba.
- Herramientas directas: A partir de la versión 1.74.0, n8n permite conectar almacenes vectoriales directamente como herramientas para el nodo de agente.
- Automatización multicanal: Capacidad de integrar el agente con más de 400 servicios, incluidos Gmail y Slack.
Versión que introdujo almacenes vectoriales como herramientas
Integraciones y servicios disponibles en n8n
Ingestión desacoplada e inferencia en vivo
Qué es un sistema RAG en n8n y qué ventajas ofrece
Los modelos de lenguaje convencionales sufren limitaciones notorias: no conocen los datos privados de una organización y tienden a generar alucinaciones cuando intentan deducir información específica. Un sistema RAG (Retrieval-Augmented Generation) soluciona este problema recuperando fragmentos exactos de información relevante antes de generar una respuesta.
En el ecosistema de n8n, el nodo AI Agent funciona como un orquestador que evalúa la pregunta del usuario, decide si necesita consultar fuentes externas mediante Tool Calling y devuelve una respuesta contextualizada conservando metadatos como enlaces y referencias documentales.
Arquitectura recomendada: Desacoplando ingestión y consulta
Un error frecuente al implementar RAG consiste en intentar leer, fragmentar y vectorizar los documentos en el mismo momento en que el usuario envía una pregunta. Este enfoque genera tiempos de respuesta lentos y un gasto innecesario en llamadas a la API de embeddings.
Carga periódica de archivos, división en bloques de texto (Text Splitter), generación de vectores y almacenamiento persistente.
Recepción del mensaje, consulta semántica a la base vectorial mediante el AI Agent y envío de la respuesta al usuario.
Requisitos previos para el tutorial
Antes de comenzar con la configuración en n8n, asegúrate de contar con los siguientes elementos:
- Una instancia activa de n8n (versión 1.74.0 o superior recomendada).
- Credenciales de API de un proveedor de modelos LLM y embeddings (como OpenAI).
- Acceso a una base de datos vectorial persistente (Pinecone, Supabase con pgvector o Qdrant).
- Documentos fuente en formatos como PDF o documentos compartidos en la nube.
Paso 1: Construir el flujo de indexación de documentos
El primer flujo se encarga de convertir documentos sin procesar en registros numéricos (vectores) dentro de tu base de conocimiento.
- Disparador (Trigger): Configura un nodo como Schedule Trigger para ejecuciones recurrentes o un conector de almacenamiento como Google Drive Trigger para procesar archivos nuevos.
- Extracción de contenido: Utiliza el nodo de lectura correspondiente para extraer el texto sin formato del archivo PDF o documento.
- Partición (Text Splitter): Conecta un subnodo de división de texto para fragmentar el contenido en bloques manejables, garantizando que el contexto no supere los límites del modelo.
- Embeddings: Conecta el modelo de incrustaciones vectoriales (Embeddings) que transformará el texto en representaciones matemáticas.
- Almacenamiento (Vector Store): Dirige los datos hacia el nodo de inserción de tu base vectorial seleccionada (por ejemplo, Pinecone o Supabase Vector Store).
| Motor Vectorial | Tipo de persistencia | Uso recomendado |
|---|---|---|
| Pinecone / Qdrant | Nube persistente dedicada | Entornos de producción corporativos |
| Supabase (pgvector) | PostgreSQL relacional + vectores | Infraestructuras unificadas de datos |
| Simple Vector Store | Memoria RAM local (volátil) | Pruebas y prototipado rápido únicamente |
Paso 2: Configurar el nodo AI Agent con herramientas vectoriales
El segundo flujo representa el cerebro interactivo. Aquí estructuramos un agente de IA con documentos capaz de razonar sobre qué fuentes consultar.
- Crear el nodo AI Agent: Añade el nodo al lienzo y selecciona el modo Tools Agent.
- Conectar el modelo de lenguaje (Chat Model): Enlaza tu proveedor LLM configurando la temperatura y credenciales adecuadas.
- Añadir memoria conversacional: Conecta un subnodo de memoria (como Window Buffer Memory) para que el agente recuerde el contexto de mensajes previos.
- Conectar Vector Store como Tool: A partir de n8n 1.74.0, puedes vincular el almacén vectorial directamente como una herramienta. En el campo Description of Data, redacta una explicación clara sobre qué documentos contiene esa base (por ejemplo: “Manuales operativos y políticas internas de la empresa”).
Ejemplo de System Prompt para el AI Agent
“Eres un asistente técnico corporativo. Tu objetivo es responder preguntas utilizando exclusivamente la herramienta de base documental provista. Si la información solicitada no se encuentra en los documentos recuperados, responde indicando con claridad que no posees registros sobre ese tema en tu base de conocimiento.”
Paso 3: Conectar canales de comunicación (Slack y Gmail)
Una vez configurada la lógica del agente, el flujo puede recibir entradas y enviar resultados hacia múltiples plataformas:
- Entrada por Webhook o Slack: Configura un disparador de eventos de Slack o un webhook HTTP para recibir las consultas de los usuarios.
- Procesamiento en subflujos: Si requieres lógica adicional, puedes invocar subflujos mediante el nodo Call n8n Workflow Tool o conectar servidores bajo el estándar Model Context Protocol (MCP) para ejecutar acciones complejas.
- Respuesta automatizada: Conecta el conector de salida hacia Gmail o canales de Slack para enviar el texto generado junto con los metadatos de las fuentes consultadas.
Errores comunes al construir agentes RAG en n8n
Durante la implementación de agentes autónomos, conviene evitar los siguientes fallos técnicos identificados en la documentación:
- Nombres de herramientas inválidos: No utilices espacios ni caracteres especiales en el nombre de los nodos de herramientas, ya que provocan fallos de validación en esquemas JSON durante las llamadas a funciones de los LLM (como OpenAI function calling).
- Descripciones semánticas ambiguas: Si el campo de descripción de la herramienta no explica con precisión qué información contiene, el modelo no sabrá cuándo activarla.
- Falta de persistencia en vectores: Emplear almacenamiento en memoria para flujos que requieren retención documental a largo plazo.
Checklist de puesta en producción
- El flujo de indexación corre separado del flujo de atención en vivo.
- Se utiliza una base vectorial persistente (Pinecone, Supabase o Qdrant).
- Los nombres de las herramientas no contienen caracteres especiales ni espacios.
- El campo “Description of Data” define con claridad el contenido del Vector Store.
- El System Prompt restringe al agente para evitar alucinaciones con datos no verificados.
🚀 ¿Quieres estar siempre actualizado en IA?
Únete a nuestra comunidad donde compartimos noticias, herramientas, guías y oportunidades sobre inteligencia artificial.
Preguntas frecuentes
¿Puedo usar el nodo Simple Vector Store en producción?
No se recomienda. El nodo Simple Vector Store opera en la memoria RAM y es volátil, lo que significa que los datos se eliminan si la instancia se reinicia o sufre restricciones de memoria. Para producción deben utilizarse opciones persistentes como Pinecone, Supabase o Qdrant.
¿Por qué mi agente de n8n no utiliza la herramienta de documentos?
Generalmente se debe a una descripción deficiente en el parámetro ‘Description of Data’ de la herramienta, o a nombres de nodos que contienen caracteres especiales incompatibles con las funciones estructuradas de los modelos LLM.
¿Es necesario re-indexar los archivos con cada mensaje recibido?
No. La indexación debe realizarse de forma desacoplada y periódica. Indexar en tiempo real aumentaría drásticamente la latencia y los costes de llamadas a modelos de embeddings.
Fuentes consultadas
🔥 Sigue Eduky Blog para más contenido sobre IA
Noticias, herramientas, automatizaciones y guías prácticas para mantenerte siempre al día.




Publicar comentario