Context Engineering: La evolución del Prompt Engineering para optimizar agentes y LLMs
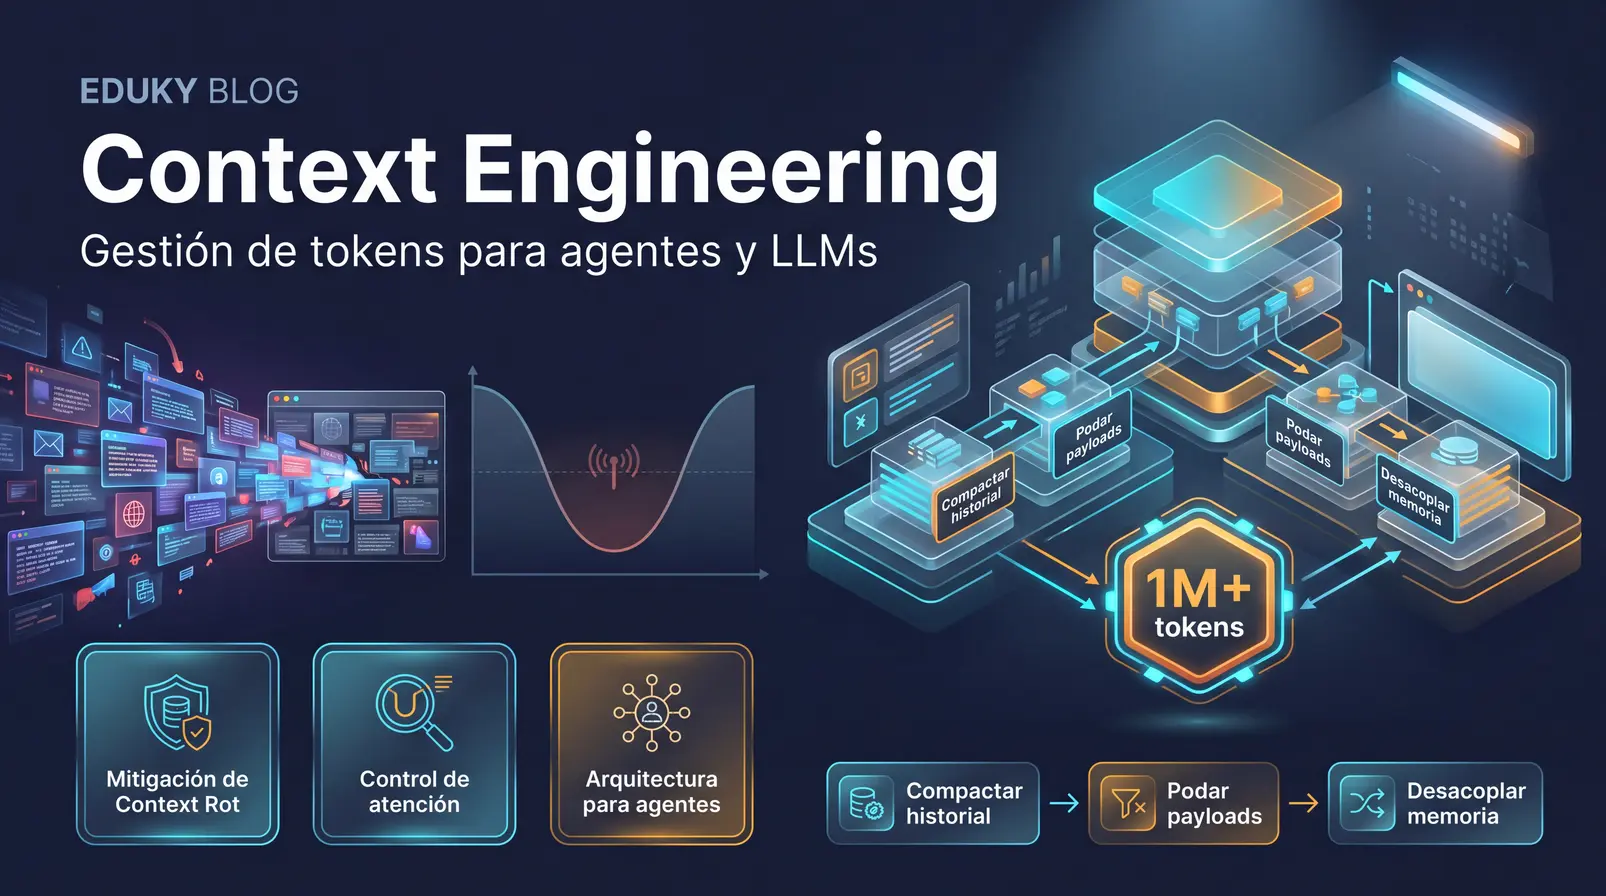
Context Engineering: La evolución del Prompt Engineering para optimizar agentes y LLMs
Descubre qué es Context Engineering, cómo mitigar el Context Rot y las técnicas clave de Anthropic para gestionar tokens en agentes y modelos LLM avanzados.
La interacción con modelos de lenguaje ha dado un salto cualitativo. Durante años, la prioridad de desarrolladores y usuarios fue el arte de redactar instrucciones aisladas; sin embargo, en sistemas multi-turno y agentes autónomos, la disciplina de Context Engineering se ha consolidado como el estándar necesario para garantizar precisión, coherencia y eficiencia en la inferencia.
Puntos clave sobre la ingeniería de contexto
- Más allá del prompt: Mientras que el prompt engineering optimiza la redacción del mensaje de entrada, Context Engineering estructura dinámicamente todo el entorno de tokens (instrucciones, herramientas, memoria e historial).
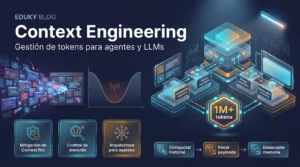
- El mito de la capacidad infinita: Ventanas de 128k, 200k o más de 1M de tokens no garantizan un rendimiento óptimo debido a fenómenos de degradación de atención.
- Degradación medible: Estudios empíricos evidencian caídas de precisión y recall a medida que se acumula ruido en el espacio de trabajo del modelo.
- Soluciones estructurales: Técnicas como la compactación de historial, la limpieza de llamadas a herramientas y la memoria desacoplada protegen la atención del transformador.
De Prompting a Context Engineering: El cambio de paradigma
El Prompt Engineering tradicional responde a una pregunta sencilla: ¿cómo redactar la instrucción para obtener la mejor respuesta en un único turno? Por el contrario, la investigación de Anthropic define Context Engineering como el conjunto de estrategias dedicadas a curar, estructurar y mantener el subconjunto óptimo de tokens durante la inferencia del modelo.
En aplicaciones reales de IA, el modelo no solo procesa la pregunta del usuario. En cada ejecución, la ventana de contexto debe albergar:
- Instrucciones del sistema (system prompts) y directrices de seguridad.
- Definiciones y esquemas de herramientas disponibles (tool definitions).
- Historial acumulado de interacciones multi-turno.
- Resultados de ejecuciones previas de código o llamadas a APIs.
- Documentos recuperados mediante arquitecturas RAG o memoria externa.
| Criterio | Prompt Engineering | Context Engineering |
|---|---|---|
| Enfoque principal | Redacción y fraseo del texto de instrucción. | Curaduría y arquitectura de todo el entorno de datos. |
| Alcance operativo | Interacciones individuales o turnos aislados. | Sistemas multi-turno, flujos de agentes y memoria persistente. |
| Gestión de tokens | Centrado en el mensaje entrante. | Control estricto de presupuestos de atención y relación señal-ruido. |
La trampa de las ventanas extensas: Context Rot y atención dispersa
El mercado actual ofrece modelos con ventanas comerciales masivas que van desde 128k y 200k hasta más de 1M de tokens. Sin embargo, disponer de espacio no significa que el modelo deba llenarse indiscriminadamente de datos sin procesar.
Capacidad física de ventanas comerciales actuales
Umbral donde estudios como Chroma Research registran caídas de precisión con datos no curados
Compaction, Tool Clearing y Memory Persistence en Anthropic
Cuando la ventana se sobrecarga con información irrelevante o desactualizada, aparecen dos problemas fundamentales en las arquitecturas basadas en Transformers:
1. Context Rot (Degradación de contexto)
El fenómeno de Context Rot describe cómo la capacidad del LLM para razonar y recuperar hechos con precisión decae progresivamente a medida que aumenta el volumen total de tokens. Esta degradación ocurre con frecuencia mucho antes de alcanzar el límite físico máximo de la ventana de contexto.
2. El efecto Lost in the Middle
Documentado formalmente por Liu et al. (2023), este efecto describe cómo los mecanismos de atención tienden a priorizar los datos situados al principio (efecto de primacía) y al final (efecto de recencia) de la ventana. La información crucial ubicada en el tercio intermedio sufre una pérdida notable de visibilidad para el modelo.
Patrones técnicos para la optimización de contexto
Para contrarrestar el ruido y sostener agentes de larga duración, la ingeniería de contexto aplica mecanismos concretos que gestionan la memoria de trabajo del sistema:
Sintetizar turnos antiguos de conversación y razonamiento previo en resúmenes densos, conservando decisiones clave sin arrastrar cientos de líneas de diálogo redundante.
Eliminar o truncar payloads masivos (como respuestas JSON crudas o logs extensos de código) una vez que el modelo ha extraído la respuesta necesaria para continuar su tarea.
Retirar bloques intermedios de pensamiento interno en turnos anteriores para evitar que la ventana se sature de deliberaciones pasadas.
Externalizar el estado de la sesión fuera de la ventana inmediata mediante sistemas de archivos o servidores Model Context Protocol (MCP), consultando datos puntuales únicamente cuando se requieren.
Cómo diseñar un flujo eficiente de Context Management
Implementar Context Engineering en agentes autónomos requiere un enfoque sistemático en el diseño de la arquitectura de datos:
- Establecer un presupuesto de tokens (Token Budget): Asignar límites específicos por sección (sistema, herramientas, memoria y respuesta).
- Posicionar datos críticos en los extremos: Colocar reglas innegociables y la instrucción actual en las posiciones de mayor peso atencional.
- Filtrar salidas de APIs antes de la inferencia: Transformar respuestas JSON voluminosas en estructuras semánticas compactas antes de agregarlas al contexto.
- Ajustar políticas según el modelo: Adaptar la agresividad de compactación según la arquitectura utilizada (familias Claude, GPT o Gemini), ya que cada una posee diferentes curvas de tolerancia al ruido.
Conclusión práctica: La efectividad de la IA avanzada no depende de cuántos tokens caben en el modelo, sino de la pureza y relevancia de la información que permites que llegue al espacio de inferencia. La ingeniería de contexto convierte ventanas caóticas en entornos de alta precisión.
Preguntas frecuentes
¿Context Engineering sustituye al Prompt Engineering?
No. La claridad de las instrucciones y el formateo semántico siguen siendo indispensables. Context Engineering engloba al prompt engineering dentro de una arquitectura más amplia que gestiona el conjunto completo de tokens.
¿Por qué falla un agente a pesar de tener una ventana amplia de contexto?
A menudo se debe al Context Rot y a la dispersión de atención por ruido acumulado (logs, payloads antiguos, razonamientos obsoletos), lo que dificulta que el transformador recupere hechos situados en posiciones intermedias.
¿Qué papel cumple el Model Context Protocol (MCP)?
Permite desacoplar el almacenamiento de datos de la ventana de inferencia, facilitando que el modelo consulte recursos y herramientas externas de manera estructurada bajo demanda sin saturar su contexto activo.
🚀 ¿Quieres estar siempre actualizado en IA?
Únete a nuestra comunidad donde compartimos noticias, herramientas, guías y oportunidades sobre inteligencia artificial.
Fuentes consultadas
🔥 Sigue Eduky Blog para más contenido sobre IA
Noticias, herramientas, automatizaciones y guías prácticas para mantenerte siempre al día.


Publicar comentario