Guía oficial de Google Cloud para prompting en modelos de razonamiento Gemini
Guía oficial de Google Cloud para prompting en modelos de razonamiento Gemini
Google Cloud publicó su guía oficial de prompting para modelos de razonamiento Gemini. Descubre cómo adaptar tus prompts sin sobrecargar su lógica interna.
El diseño de instrucciones para inteligencia artificial ha dado un giro definitivo. Si solías añadir la clásica coletilla «piensa paso a paso» a cada consulta, las nuevas directrices técnicas obligan a cambiar de estrategia. Con la publicación oficial de la Thinking prompting guide dentro de la documentación técnica de Google Cloud (Gemini Enterprise Agent Platform) en octubre de 2026, la compañía establece las bases formales para el prompting modelos de razonamiento gemini.
Esta documentación se enfoca en las arquitecturas con soporte de razonamiento interno como Gemini 2.5 y Gemini 3. A diferencia de los modelos generativos tradicionales, estas redes ejecutan un proceso de reflexión oculto antes de escribir una sola palabra. Comprender cómo interactuar con este mecanismo no solo previene bloqueos lógicos, sino que evita sobrecostes innecesarios en tus desarrollos.
Claves rápidas de la guía de Google Cloud
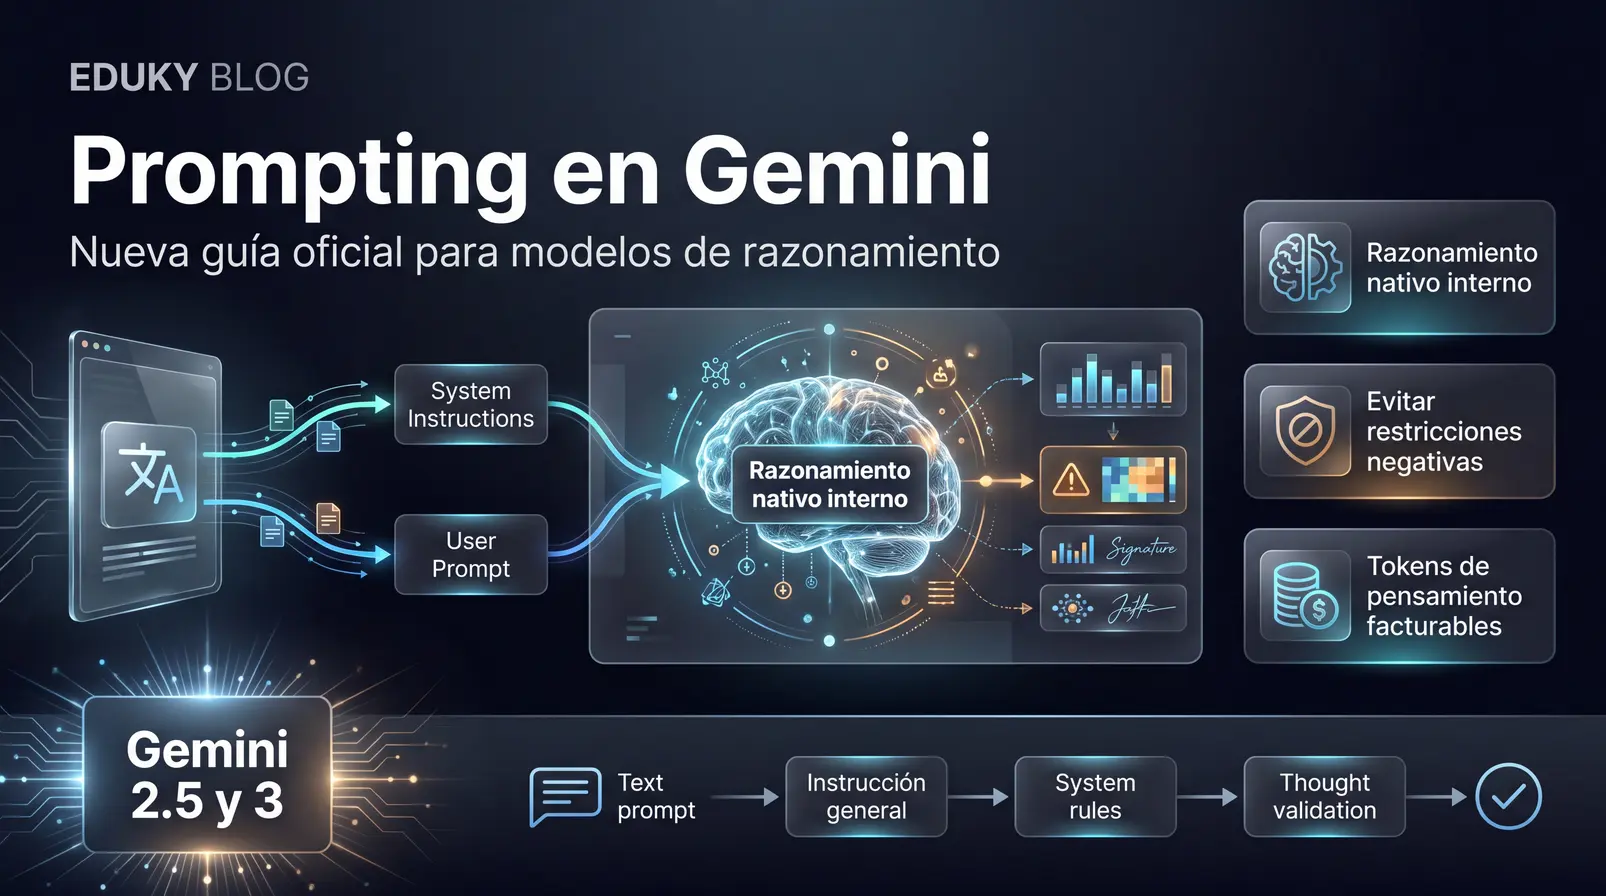
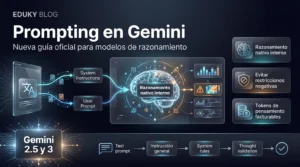
- Razonamiento nativo: Los modelos como Gemini 2.5 y Gemini 3 ya integran una cadena de pensamiento interna; no necesitan frases como «piensa paso a paso» en el texto visible.
- De lo simple a lo complejo: La recomendación oficial es comenzar con directrices generales para comprobar la deducción natural del modelo antes de fragmentar la tarea.
- Cuidado con las restricciones: Comandos negativos como «no deduzcas nada» o «do not guess» pueden paralizar cálculos elementales y síntesis lógicas.
- Separación estructural: El rol, tono y formato van en las system instructions; la ruta de resolución debe quedar libre para el motor interno.
- Control técnico: Se introducen parámetros como
thinking_levelo el presupuesto de tokens para ajustar latencia y consumo facturable.
El cambio de paradigma: Del CoT forzado al pensamiento nativo
Durante años, la técnica estándar para resolver problemas complejos con modelos de lenguaje fue el llamado Chain of Thought (CoT) explícito. Se obligaba al modelo a generar en su respuesta visible todo el desglose intermedio para inducir una respuesta correcta. Sin embargo, en los modelos de razonamiento de Google Cloud, el motor procesa el problema internamente (thinking process) de forma previa a la salida de tokens finales.
Forzar al modelo a escribir sus pasos intermedios de forma rígida puede entrar en conflicto con su propio razonamiento interno, introduciendo redundancia y aumentando la latencia inicial (Time to First Token).
| Criterio | LLM Tradicional (CoT en salida) | Modelo de Razonamiento Gemini |
|---|---|---|
| Gatillo de razonamiento | Requiere «piensa paso a paso» en el prompt. | Automático e interno antes del primer token visible. |
| Instrucciones negativas | Fácilmente ignoradas o acatadas parcialmente. | Riesgo de sobreenfoque: bloquea deducciones lógicas válidas. |
| Facturación de tokens | Solo tokens de entrada y salida visibles. | Los tokens del proceso de pensamiento interno son facturables. |
Pautas oficiales de Google Cloud para estructurar tus prompts
La Thinking prompting guide formaliza varias prácticas esenciales orientadas a maximizar la precisión lógica de los modelos Gemini de última generación:
Google aconseja evaluar la capacidad analítica natural del modelo planteando el problema en términos amplios antes de sobrecargar el prompt con desgloses detallados.
Configura las reglas de negocio, el formato de salida y el rol dentro de las instrucciones de sistema, permitiendo que el prompt de usuario se enfoque únicamente en la tarea.
Proporciona ejemplos de pares entrada-salida para enseñar el formato esperado, sin imponer una estructura rígida en cómo debe reflexionar internamente.
Separación limpia: Instrucciones de Sistema vs. Prompt de Usuario
Para dominar el prompting modelos de razonamiento gemini, la documentación subraya la importancia de mantener una clara separación funcional:
- System Instructions: Define la personalidad, restricciones operativas inmutables y el esquema de entrega (por ejemplo, devolver estrictamente un objeto JSON).
- User Prompt: Presenta los datos crudos, la consulta y el contexto específico del problema a resolver.
Ejemplo práctico: Análisis financiero estructurado
Configuración recomendada por las directrices de Google:
Instrucción de sistema: «Actúa como analista financiero senior. Entrega las conclusiones clave y ratios calculados exclusivamente en formato JSON válido según el esquema previsto.»
Prompt de usuario: «Analiza los siguientes tres párrafos del informe trimestral y calcula la tasa de crecimiento interanual del margen operativo.»
Resultado esperado: El modelo ejecuta internamente la extracción de cifras y las fórmulas aritméticas sin que debas especificarle «primero busca el dato A, luego el dato B y réstalos».
Control técnico: Tokens facturables, Thinking Level y Thought Signatures
Trabajar con razonamiento nativo introduce consideraciones técnicas y de infraestructura cruciales para entornos de producción en Vertex AI o la API de Gemini:
Niveles de
thinking_level configurables en Gemini 3 para controlar latencia y profundidad analítica.
Límite de tokens de pensamiento asignables en Gemini 2.5 para acotar el gasto en operaciones recurrentes.
Fallo técnico devuelto si se omiten las thought signatures en conversaciones multi-turno o llamadas a funciones.
En implementaciones avanzadas, cada ciclo de pensamiento produce una thought signature: una representación criptográfica del estado mental del modelo. Google Cloud documenta que, en llamadas a funciones (function calling) y flujos conversacionales, estas firmas deben preservarse y enviarse de vuelta a la API. Omitir estos objetos puede romper la coherencia del modelo y provocar errores de cliente en la serie Gemini 3.
Checklist: Cuándo activar o limitar los modelos Thinking
- Ideal para: Problemas matemáticos, depuración de código complejo, deducción lógica de múltiples documentos y conciliación de datos.
- No recomendado para: Clasificación de texto directa, extracción simple de entidades o tareas donde la latencia baja sea la prioridad crítica.
- Gestión de costes: Recuerda que los tokens de pensamiento ocultos computan en el uso facturable total de la consulta.
🚀 ¿Quieres estar siempre actualizado en IA?
Únete a nuestra comunidad donde compartimos noticias, herramientas, guías y oportunidades sobre inteligencia artificial.
Preguntas frecuentes
¿Debo dejar de usar «piensa paso a paso» en todos los modelos?
Esta técnica sigue siendo útil en modelos generativos tradicionales que no disponen de un proceso de razonamiento nativo. Sin embargo, en modelos como Gemini 2.5 y Gemini 3, Google desaconseja forzarla en el texto final ya que el razonamiento ocurre internamente.
¿Por qué las restricciones como «no deduzcas nada» causan errores?
Porque el modelo dedica su capacidad de razonamiento a evitar cualquier inferencia, lo que a menudo bloquea cálculos matemáticos sencillos o la capacidad de conectar dos datos evidentes en el mismo documento.
¿Los tokens generados durante el razonamiento interno se cobran?
Sí. Google Cloud especifica que los tokens utilizados por el modelo durante su proceso de pensamiento computan dentro del uso facturable de la API, además de impactar en el tiempo previo a emitir la primera palabra.
Fuentes consultadas
🔥 Sigue Eduky Blog para más contenido sobre IA
Noticias, herramientas, automatizaciones y guías prácticas para mantenerte siempre al día.

Publicar comentario