RAG con LangChain desde cero: arquitectura, fragmentación y recuperación vectorial
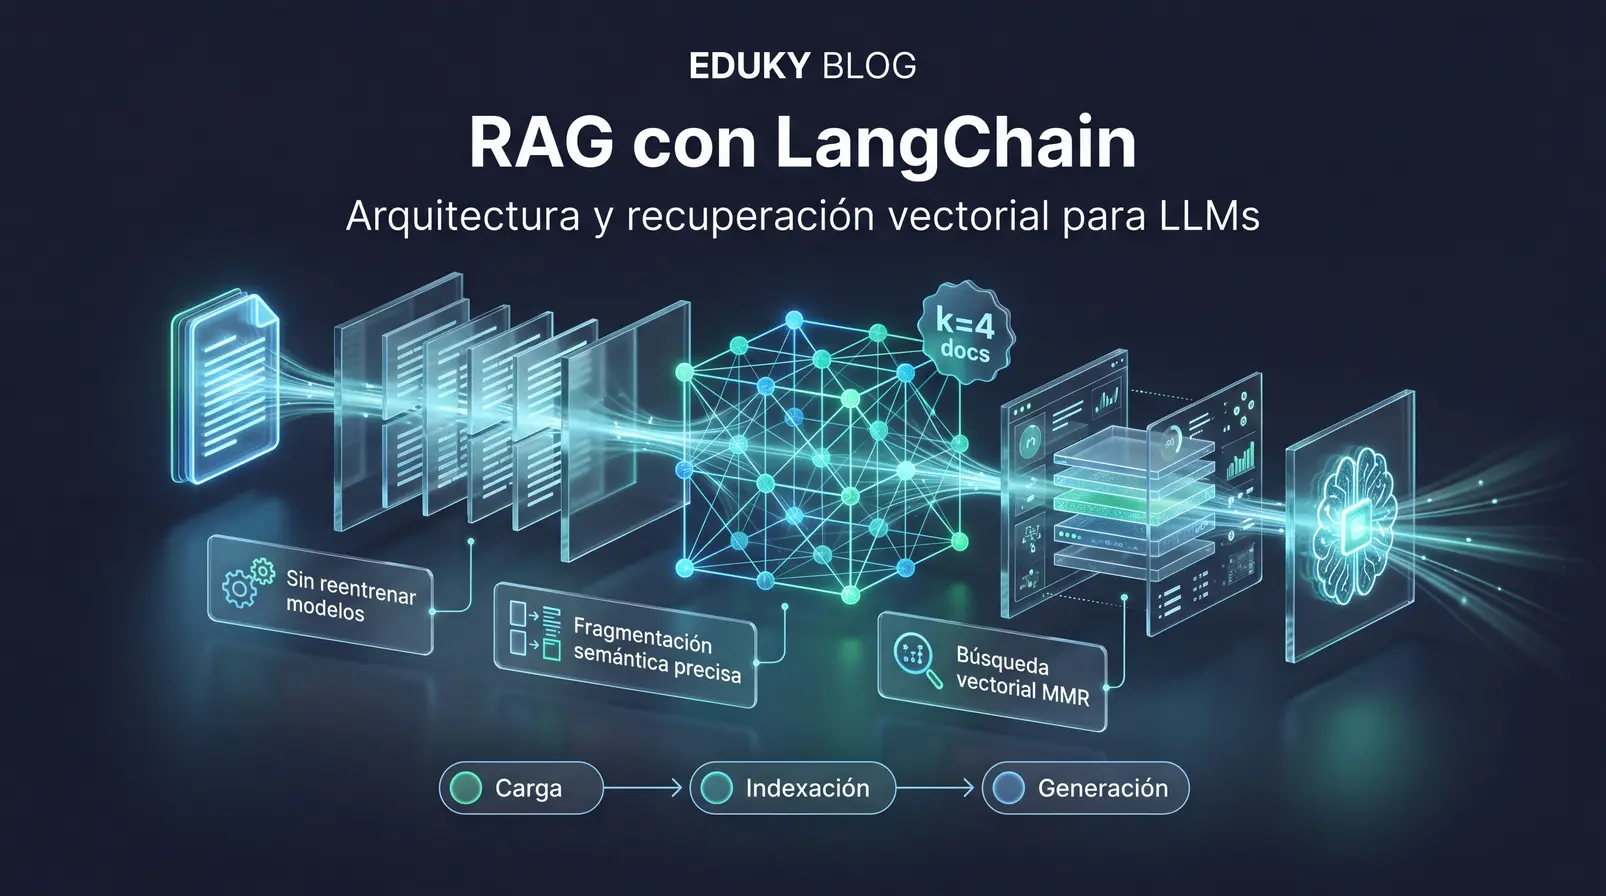
RAG con LangChain desde cero: arquitectura, fragmentación y recuperación vectorial
Aprende a conectar documentos privados a modelos de lenguaje con este RAG LangChain tutorial. Domina chunking, embeddings y bases de datos vectoriales.
Conectar bases de conocimiento externas a modelos de lenguaje es el estándar para eliminar alucinaciones y trabajar con datos privados actualizados. En este RAG LangChain tutorial, exploramos la arquitectura paso a paso de Retrieval-Augmented Generation (RAG), abordando desde la ingesta estructurada y las técnicas de fragmentación semántica hasta la recuperación vectorial optimizada.
Claves de la arquitectura RAG
- Cero reentrenamiento: Permite consultar información privada o reciente inyectando contexto dinámico en el prompt del LLM.
- Dos pipelines esenciales: La indexación de datos (carga, división y vectorización) y la recuperación-generación en tiempo de consulta.
- División semántica: El uso de
RecursiveCharacterTextSplitterpreserva la estructura del texto evitando pérdida de significado. - Búsqueda vectorial diversa: Algoritmos como MMR (Maximal Marginal Relevance) evitan respuestas redundantes en el modelo.
¿Qué es RAG y qué limitaciones resuelve en los modelos de lenguaje?
Los modelos de lenguaje masivos (LLM) están limitados por su fecha de corte de entrenamiento y por la falta de acceso a datos privados internos. Al enfrentarse a preguntas fuera de su conocimiento base, suelen generar respuestas incorrectas o inventadas, un fenómeno conocido como alucinación.
Retrieval-Augmented Generation (RAG) resuelve este problema dividiendo la tarea en dos partes: primero busca información relevante en una base de datos externa y luego la entrega al modelo junto con la consulta del usuario. De este modo, el LLM actúa como un motor de razonamiento y síntesis sobre hechos concretos, en lugar de depender únicamente de su memoria paramétrica.
Documentos contextuales recuperados por defecto en consultas estándar
Dimensiones habituales en vectores de modelos de embeddings
Configuración común de chunk_size y chunk_overlap en caracteres
Anatomía de un sistema RAG: los dos pipelines fundamentales
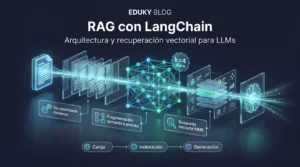
La implementación de Retrieval-Augmented Generation en Python mediante LangChain se estructura a través de dos flujos de trabajo independientes pero complementarios: el pipeline de indexación y el pipeline de consulta.
Extracción de texto crudo desde archivos fuente (como PDFs o archivos de texto plano) mediante Document Loaders.
División del texto en bloques manejables para ajustarse a los límites de contexto y optimizar la precisión semántica.
Transformación de fragmentos en vectores densos mediante modelos de embeddings y persistencia en un Vector Store.
Búsqueda de fragmentos relevantes para la consulta del usuario y ensamblado del prompt final para el LLM.
Estrategias de fragmentación: el rol de RecursiveCharacterTextSplitter
Uno de los factores determinantes al conectar documentos a LLM con LangChain es la estrategia de fragmentación (chunking). Si los fragmentos son demasiado pequeños, se pierde contexto esencial; si son excesivamente grandes, se diluye la señal semántica y se incrementa el consumo de tokens en la llamada al modelo.
LangChain recomienda RecursiveCharacterTextSplitter como la estrategia estándar para texto genérico. Esta herramienta opera dividiendo de forma jerárquica mediante una lista de separadores predeterminados (doble salto de línea, salto simple, espacios y finalmente caracteres vacíos), intentando conservar párrafos completos y oraciones antes de forzar un corte.
Parámetros clave de fragmentación
- chunk_size (ej. 1000): Define la cantidad máxima de caracteres por fragmento.
- chunk_overlap (ej. 200): Número de caracteres que se repiten entre fragmentos contiguos para preservar el contexto en los límites de cada corte.
Embeddings y bases de datos vectoriales en LangChain
Una vez fragmentado el documento, cada segmento de texto debe convertirse en un vector denso dentro de un espacio multidimensional. Los modelos de embeddings capturan la semántica del lenguaje: fragmentos con significados afines quedan posicionados cerca en el espacio vectorial, lo que permite realizar búsquedas por similitud coseno o distancia euclidiana.
Al configurar el recuperador (retriever), LangChain ofrece distintos algoritmos para seleccionar los fragmentos que se incluirán en el contexto del modelo:
| Estrategia de búsqueda | Mecanismo principal | Caso de uso idóneo |
|---|---|---|
| Similarity Search | Recupera los k vectores con mayor proximidad semántica respecto a la consulta. | Preguntas puntuales directas y consultas homogéneas. |
| Maximal Marginal Relevance (MMR) | Equilibra la similitud semántica con la diversidad entre los fragmentos seleccionados. | Bases documentales con contenido repetitivo donde se requiere variedad de contexto. |
Construcción del pipeline y prevención de alucinaciones
Con los documentos indexados y el recuperador activo, el paso final consiste en armar la cadena de generación. Utilizando LangChain Expression Language (LCEL) o herramientas de orquestación como LangGraph, se define una estructura donde la consulta del usuario alimenta simultáneamente al recuperador y al formateador del prompt.
El LLM recibe una instrucción explícita: responder la consulta apoyándose exclusivamente en los fragmentos de texto provistos. Si la información no se encuentra en el contexto recuperado, el modelo debe señalarlo, reduciendo radicalmente el riesgo de alucinaciones.
Checklist para implementar RAG con éxito
- Elegir el cargador documental adecuado según el tipo de archivo (PyPDFLoader, TextLoader, etc.).
- Ajustar
chunk_sizeychunk_overlapevaluando la coherencia semántica de los fragmentos. - Seleccionar un modelo de embeddings con la dimensionalidad requerida para el proyecto.
- Configurar el número de fragmentos a recuperar (parámetro k) y la estrategia (Similitud o MMR).
- Alinear las instrucciones del prompt del sistema para restringir la respuesta al contexto recuperado.
Conclusión práctica: Retrieval-Augmented Generation no sustituye el entrenamiento de modelos, sino que proporciona una capa de acceso dinámico a la verdad. Una adecuada fragmentación jerárquica y una recuperación diversa son los dos pilares que garantizan precisión y eficiencia en costes.
Preguntas frecuentes
¿Por qué es necesario el solapamiento (overlap) al dividir documentos?
El parámetro de solapamiento garantiza que las oraciones o ideas ubicadas justo en el límite entre dos fragmentos no pierdan su significado contextual al ser divididas.
¿Qué diferencia a MMR de una búsqueda de similitud estándar?
La búsqueda de similitud estándar devuelve los fragmentos más cercanos a la consulta sin evaluar si dicen lo mismo. MMR penaliza fragmentos casi idénticos para aportar un contexto más variado al LLM.
🚀 ¿Quieres estar siempre actualizado en IA?
Únete a nuestra comunidad donde compartimos noticias, herramientas, guías y oportunidades sobre inteligencia artificial.
Fuentes consultadas
🔥 Sigue Eduky Blog para más contenido sobre IA
Noticias, herramientas, automatizaciones y guías prácticas para mantenerte siempre al día.


Publicar comentario