Fundamentos de RAG: arquitectura y bases vectoriales para conectar LLMs a tus datos
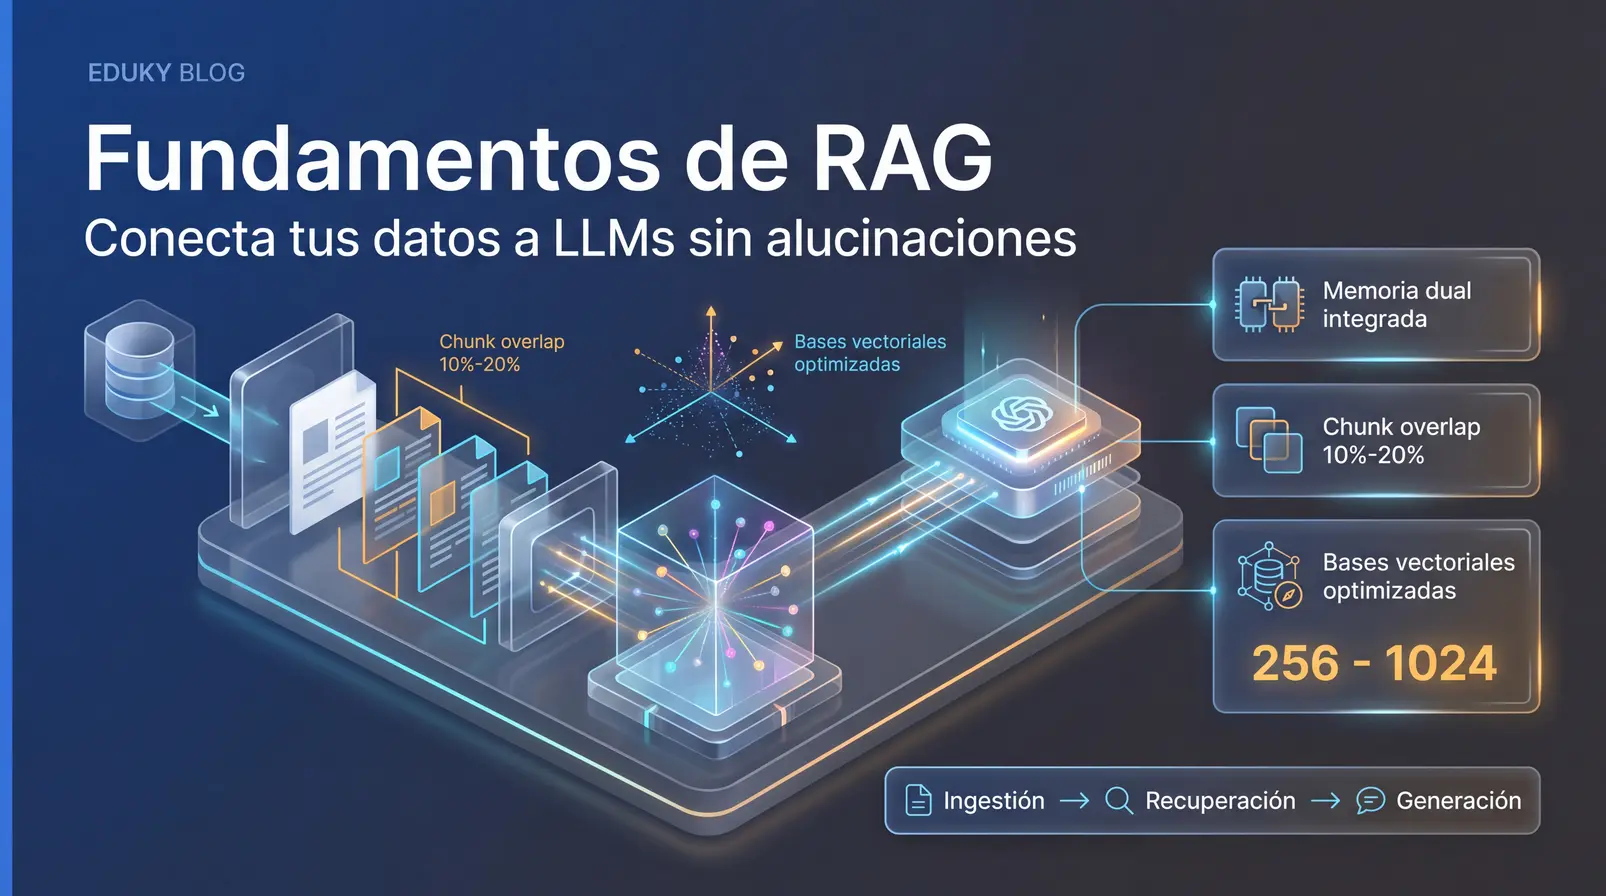
Fundamentos de RAG: arquitectura y bases vectoriales para conectar LLMs a tus datos
Descubre los fundamentos de RAG: cómo conectar modelos de lenguaje con bases vectoriales mediante chunking y embeddings para eliminar alucinaciones.
Los modelos de lenguaje más avanzados pueden redactar código impecable y razonar con fluidez, pero tropiezan cuando deben responder sobre manuales internos, normativas actualizadas o datos corporativos confidenciales. Dominar los fundamentos de RAG (Retrieval-Augmented Generation) es el paso técnico definitivo para transformar un modelo genérico en un asistente fundamentado en hechos comprobables, combinando el poder del razonamiento artificial con bases de datos externas.
Claves del sistema RAG
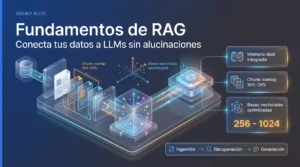
- Memoria dual: Separa el razonamiento lingüístico (memoria paramétrica) del archivo documental dinámico (memoria no paramétrica).
- Cuatro fases canónicas: El ciclo de vida opera mediante Ingestión, Recuperación, Aumento y Generación.
- Solapamiento estratégico: Mantener un chunk overlap del 10% al 20% preserva la coherencia entre fragmentos de texto.
- Eficiencia frente a reentrenar: RAG supera al Fine-Tuning en actualización inmediata de datos, control de permisos y reducción de costes en GPUs.
Qué es Retrieval-Augmented Generation: la analogía del examen
Para entender qué resuelve esta técnica, conviene recurrir a una comparación pedagógica. Un gran modelo de lenguaje (LLM) aislado opera como un estudiante ante un examen de memoria cerrada: debe confiar exclusivamente en lo que asimiló durante su entrenamiento previo. Si el dato cambió ayer o pertenece a un PDF privado de tu empresa, el modelo recurrirá a aproximaciones probabilísticas, generando respuestas plausibles pero falsas conocidas como alucinaciones.
RAG convierte esa prueba en un examen a libro abierto. En lugar de forzar al modelo a memorizar cada detalle del mundo, el sistema busca los fragmentos documentales pertinentes y se los entrega directamente en la consulta antes de que empiece a escribir.
Los modelos fundacionales presentan restricciones intrínsecas difíciles de eludir únicamente mediante prompts convencionales:
- Fechas de corte (knowledge cutoffs): Incapacidad de conocer eventos o documentación creada tras su entrenamiento.
- Ausencia de datos privados: Los repositorios internos, wikis de soporte y contratos empresariales no forman parte de los conjuntos de entrenamiento públicos.
- Carencia de trazabilidad: Un modelo base no puede citar con certeza exacta el párrafo original que respalda su afirmación.
Año de origen formal del concepto RAG por Patrick Lewis et al.
Fases del ciclo: Ingestión, Recuperación, Aumento y Generación
Rango estándar recomendado para chunk overlap
Tokens habituales por fragmento para balancear contexto
Retrieval Augmented Generation: arquitectura y ciclo de vida en 4 etapas
El funcionamiento de una solución basada en RAG no ocurre en un único bloque monolítico. Se estructura en una secuencia técnica que divide las tareas offline (preparación documental) de las tareas online (respuesta en tiempo real ante la consulta del usuario).
Los documentos en bruto (PDFs, bases de conocimiento o páginas web) se extraen, se limpian, se dividen en fragmentos manejables y se transforman en vectores numéricos mediante un modelo de embeddings.
Cuando el usuario introduce una consulta, esta se vectoriza en el mismo espacio semántico para buscar y extraer los fragmentos más afines dentro de la base vectorial.
Se construye un prompt enriquecido inyectando los fragmentos recuperados junto con las instrucciones del sistema y la pregunta original del usuario.
El LLM procesa el prompt contextualizado y redacta una respuesta fundamentada (grounding) respaldada de forma verificable por los fragmentos suministrados.
La ciencia del Chunking: tamaño, solapamiento y granularidad
El primer cuello de botella técnico de un sistema RAG reside en cómo se segmenta la información. Si un fragmento es diminuto, carecerá del contexto necesario para que el modelo comprenda la idea general; si es desmesurado, diluirá el significado semántico e introducirá ruido innecesario en la ventana de contexto.
Tamaño del fragmento (Chunk Size)
En implementaciones estándar, el rango habitual oscila entre 256 y 1024 tokens. Este tamaño permite capturar párrafos conceptuales completos sin desbordar el espacio de atención del modelo ni mezclar temáticas dispares en un mismo vector.
El rol crítico del solapamiento (Chunk Overlap)
Al trocear un texto largo, cortar abruptamente una frase puede quebrar la relación gramatical o anafórica de una idea. Para evitar que el sujeto de una afirmación quede en el fragmento anterior y el predicado en el siguiente, se implementa una ventana de solapamiento.
Embeddings y bases vectoriales en inteligencia artificial
Para que una máquina compare significados y no simples cadenas tipográficas, los fragmentos deben traducirse a representaciones numéricas: los embeddings semánticos. Un modelo de incrustación convierte el texto en listas de números flotantes (vectores) dentro de un espacio multidimensional donde los conceptos similares quedan ubicados a escasa distancia espacial.
Las bases de datos vectoriales están optimizadas para almacenar estos vectores y ejecutar búsquedas de vecinos más cercanos (k-NN) a alta velocidad utilizando métricas matemáticas como la similitud de coseno. Sin embargo, no todas las alternativas del mercado responden a las mismas necesidades operativas:
- Sistemas nativos cloud serverless (Pinecone): Diseñados para delegar la infraestructura de servidores, priorizando alta disponibilidad, escalabilidad horizontal automática y mantenimiento simplificado.
- Librerías locales y embebidas (Chroma): Idóneas para prototipos rápidos, entornos de desarrollo local, pruebas unitarias y arquitecturas edge sin dependencias externas.
- Motores open-source escalables (Qdrant, Milvus): Pensados para organizaciones que requieren soberanía absoluta sobre sus datos en infraestructura propia, compatibilidad con cargas híbridas y capacidades avanzadas de filtrado por metadatos.
RAG vs. Fine-Tuning: diferencias de arquitectura y costes
Uno de los dilemas recurrentes al diseñar aplicaciones con LLMs es decidir si ajustar los pesos internos del modelo (Fine-Tuning) o conectar una base externa (RAG). Ambos métodos cumplen funciones complementarias pero resuelven problemas completamente distintos.
| Criterio | Retrieval-Augmented Generation (RAG) | Fine-Tuning (Ajuste Fino) |
|---|---|---|
| Objetivo primario | Incorporar conocimiento fáctico dinámico y privado. | Adaptar estilo, tono, sintaxis o tareas de dominio específico. |
| Actualización de datos | Instantánea (basta con añadir o borrar vectores en la base). | Lenta y costosa (requiere preparar datasets y reentrenar). |
| Coste computacional | Bajo coste recurrente en GPUs; enfocado en almacenamiento vectorial. | Elevado gasto computacional durante los ciclos de entrenamiento. |
| Trazabilidad y fuentes | Alta: cita directamente el fragmento y documento de origen. | Nula: la información se diluye dentro de los parámetros del modelo. |
| Control de acceso | Granular mediante metadatos y filtros por usuario o rol. | Inexistente: todos los pesos entrenados están disponibles globalmente. |
Estrategias avanzadas: búsqueda híbrida y límites operativos
A medida que los sistemas documentales crecen, la recuperación exclusivamente semántica muestra debilidades puntuales. Si un usuario busca una referencia numérica de inventario, un código de error o un acrónimo técnico muy específico, los vectores densos pueden generar coincidencias imprecisas debido a la abstracción semántica.
Para resolver este desafío surge la búsqueda híbrida (hybrid search), que combina dos mundos:
- Búsqueda densa (vectores semánticos): Captura la intención contextual y sinónimos conceptuales.
- Búsqueda dispersa (vectores léxicos o algoritmos como BM25): Localiza coincidencias literales exactas en números de serie, nombres propios o terminología técnica interna.
Checklist para auditar una arquitectura RAG
- Validar que el tamaño de fragmento (chunk size) se sitúe entre 256 y 1024 tokens según la estructura del texto.
- Configurar un solapamiento (overlap) de entre el 10% y el 20% para evitar rupturas de oraciones.
- Seleccionar la base vectorial adecuada (Pinecone para serverless gestionado, Chroma para prototipos locales o Qdrant para soberanía de datos).
- Implementar búsqueda híbrida si la documentación contiene acrónimos, números de parte o códigos internos.
- Aplicar metadatos para permitir filtrado por permisos de usuario antes de inyectar el contexto.
Preguntas frecuentes
¿Por qué no usar ventanas de contexto de millones de tokens en vez de RAG?
Inyectar documentos completos en cada llamada al LLM dispara los costes de inferencia y la latencia de respuesta de forma insostenible. Además, los modelos pueden sufrir pérdida de atención frente a datos ubicados en las zonas intermedias del texto largo.
¿RAG elimina todas las alucinaciones por completo?
No al 100%. RAG reduce drásticamente las invenciones fácticas, pero si el motor de búsqueda recupera información desactualizada, incompleta o contradictoria, el modelo generará inferencias incorrectas a partir de ese material.
¿Cuándo conviene elegir Fine-Tuning en lugar de RAG?
Fine-Tuning es idóneo cuando necesitas modificar el comportamiento, tono, formato estructurado o estilo lingüístico del modelo. RAG es la opción indicada cuando el objetivo es conectar datos fácticos que cambian periódicamente o requieren trazabilidad documental.
Comprender los fundamentos de RAG permite construir sistemas de inteligencia artificial fiables, gobernables y económicamente viables. La clave de un rendimiento óptimo no reside en utilizar el modelo lingüístico más grande, sino en diseñar con precisión la fragmentación, el solapamiento y la estrategia de recuperación en la base vectorial.
🚀 ¿Quieres estar siempre actualizado en IA?
Únete a nuestra comunidad donde compartimos noticias, herramientas, guías y oportunidades sobre inteligencia artificial.
Fuentes consultadas
🔥 Sigue Eduky Blog para más contenido sobre IA
Noticias, herramientas, automatizaciones y guías prácticas para mantenerte siempre al día.

Publicar comentario